目次
この記事はヌーラボブログリレー2026 夏の19日目として投稿しています。
こんにちは。ヌーラボの渡邉です。最近は、「AI Integration Unit」で、AIエージェントに関わる仕事をしています。今回は少し目線を変えて、古典的なKVSの中身をGoで追ってみます。キーと値を保存し、必要なときに取り出す。その仕組みを支えるデータ構造とアルゴリズムについて、SDBMを再実装しながら学んだことを紹介します。
目次
はじめに
キーバリューストア(KVS)の基本的な仕組みを実装から理解したくて、古典的なKVSであるSDBMをGoで再実装しました。それが、go-sdbm です。
SDBMは、キーと値の組をファイルで管理するDBMライブラリの一つで、Ozan Yigit氏による実装です。Perlの SDBM_File、Rubyの sdbm、Apache Portable Runtimeの SDBMライブラリ にも、その系譜を見ることができます。
今回参照したCの実装は、hash.c、pair.c、sdbm.c の3ファイルで、コメント・空行を含めても合計900行弱です。保存・検索・削除・拡張の仕組みを追うには、ちょうどよい大きさでした。
この記事では、キーと値はファイルのどこに置かれ、保存先がいっぱいになったらどうなるのかを、Goのコードと数件のデータで確かめます。
Goの基本的な文法が分かる方を想定し、DBの内部用語は本文で説明します。最後には、本文の例を手元で再現するサンプルを用意しています。
まず、保存・取得・削除を使ってみる
内部の仕組みを見る前に、利用する側の操作を確認します。go-sdbmは、キーと値をバイト列として扱います。コードで使う Datum は []byte に名前を付けた型で、sdbm.Datum("a") と書くと文字列をキー用のバイト列に変換できます。
DBを開くのが Open 関数です。返された DBM 型の値を通じて、保存する Store、取得する Fetch、削除する Delete の各メソッドを呼びます。次は a → apple を保存し、取得して表示した後、削除する最小限のプログラムです。
GO · 保存・取得・削除の使用例
package main

import (
    "fmt"
    "os"

    "github.com/vvatanabe/go-sdbm"
)

func main() {
    db, err := sdbm.Open("example", os.O_CREATE|os.O_RDWR, 0600)
    if err != nil { panic(err) }
    defer func() {
        if err := db.Close(); err != nil { panic(err) }
    }()

    key := sdbm.Datum("a")

    // 保存:同じキーがあれば値を置き換える
    _, err = db.Store(key, sdbm.Datum("apple"), sdbm.StoreREPLACE)
    if err != nil { panic(err) }

    // 取得:削除する前に値を表示する
    value, err := db.Fetch(key)
    if err != nil { panic(err) }
    fmt.Printf("a -> %s\n", value)

    // 削除:戻り値で、削除できたかを確認する
    deleted, err := db.Delete(key)
    if err != nil { panic(err) }
    fmt.Printf("deleted: %t\n", deleted)
}
Open にはファイル名の共通部分として example を渡します。os.O_CREATE | os.O_RDWR は、ファイルがなければ作り、読み書きできる状態で開く指定です。0600 は作成時のアクセス権で、所有者だけに読み書きを許可します。使い終えたDBは、defer で予約した Close メソッドで閉じます。
StoreREPLACE 定数は、同じキーがすでにあれば値を置き換える指定です。Fetch で取得した値は、その場で表示しています。Delete の戻り値 deleted は、キーが見つかって削除できたかを表します。
OUTPUT · 使用例の出力
a -> apple
deleted: true
保存・取得・削除は、このように呼び出せます。では、保存した apple はファイルのどこに置かれ、キー a からどう見つけられるのでしょうか。まず、SDBMが使う二つのファイルの役割を見ていきます。
キーと値を、ファイルのどこに保存するか
二つのファイルの役割
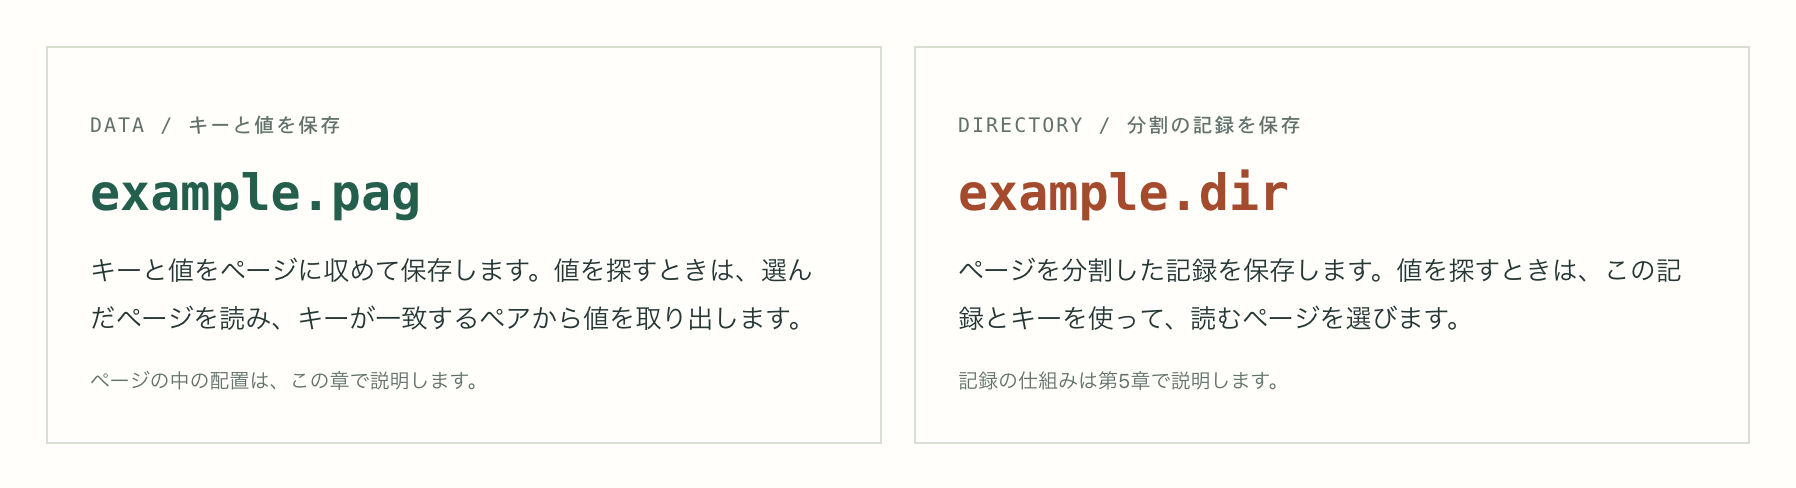
SDBMは一つのDBを、役割の異なる二つのファイルで管理します。キーと値の組をペア、データを収める固定長の領域をページと呼びます。
二つのファイルに、何を保存するか
先ほどの使用例は最後に a を削除しました。ここからは新しいDBに a → apple を保存した状態から、ページの中を見ます。続いて値を300バイトに大きくし、ページが分かれる様子を追います。説明に使う数値は、リポジトリのサンプルプログラムで確かめられます。
1ページは1024バイト
1ページを表す Page 構造体は、固定長のバイト配列 buf だけを持ちます。
GO · Page 構造体 pair.go ↗
type Page struct {
    buf [PBLKSIZ]byte
}
配列の長さを定める定数は、sdbm.go の PBLKSIZ = 1024 です。つまり buf は1024バイトで、バイト位置は0から1023。1024は最後のバイトの、一つ先の境界です。
まずキーを置き、その手前に値を置く
空のページに a → apple を入れてみましょう。末尾の境界1024からキーの長さ1を引き、位置1023に a を置きます。さらに値の長さ5を引き、位置1018から apple を置きます。
末尾の6バイトを拡大する
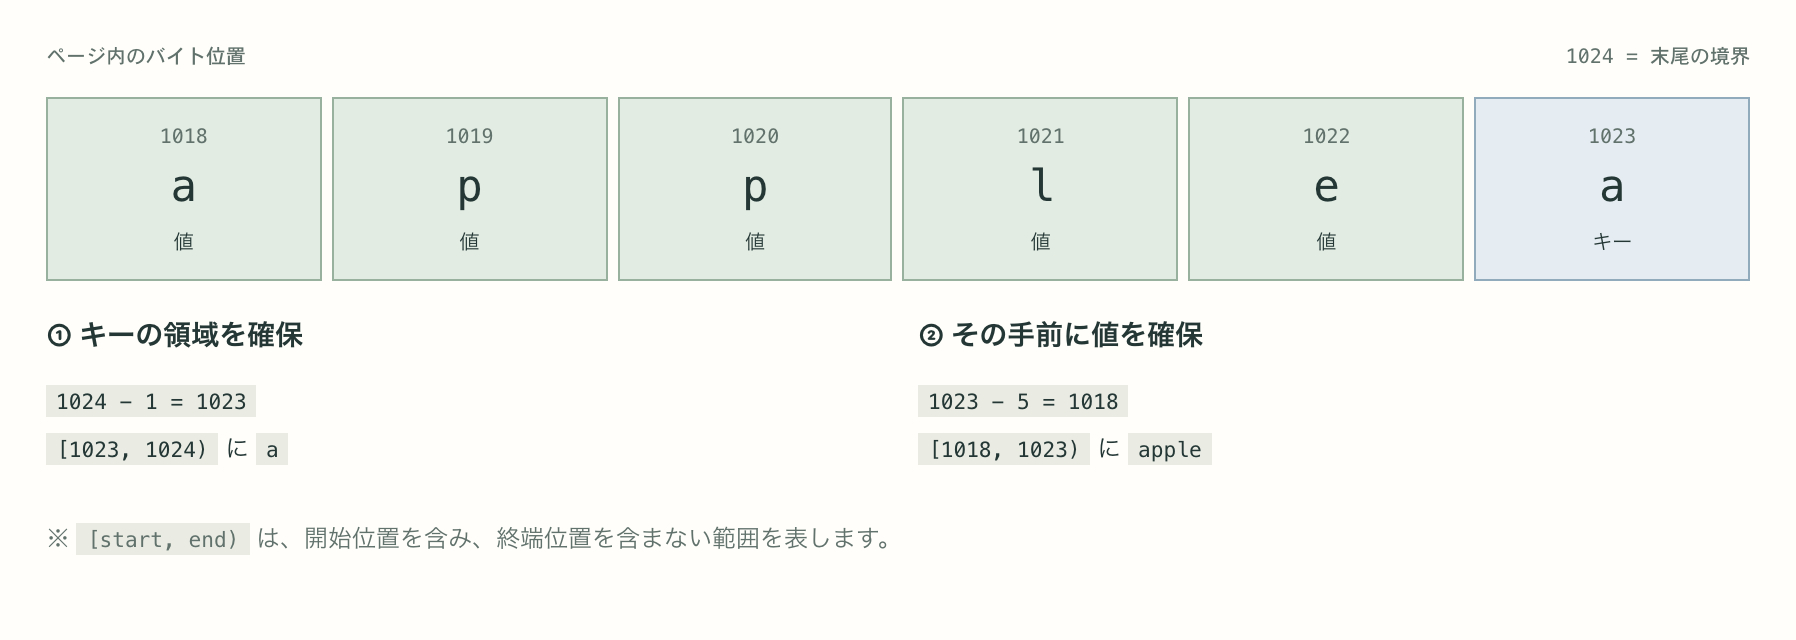
「後方から詰める」のは領域の確保順です。文字の並びは通常のままなので、先頭側から本体を読むと applea に見えます。
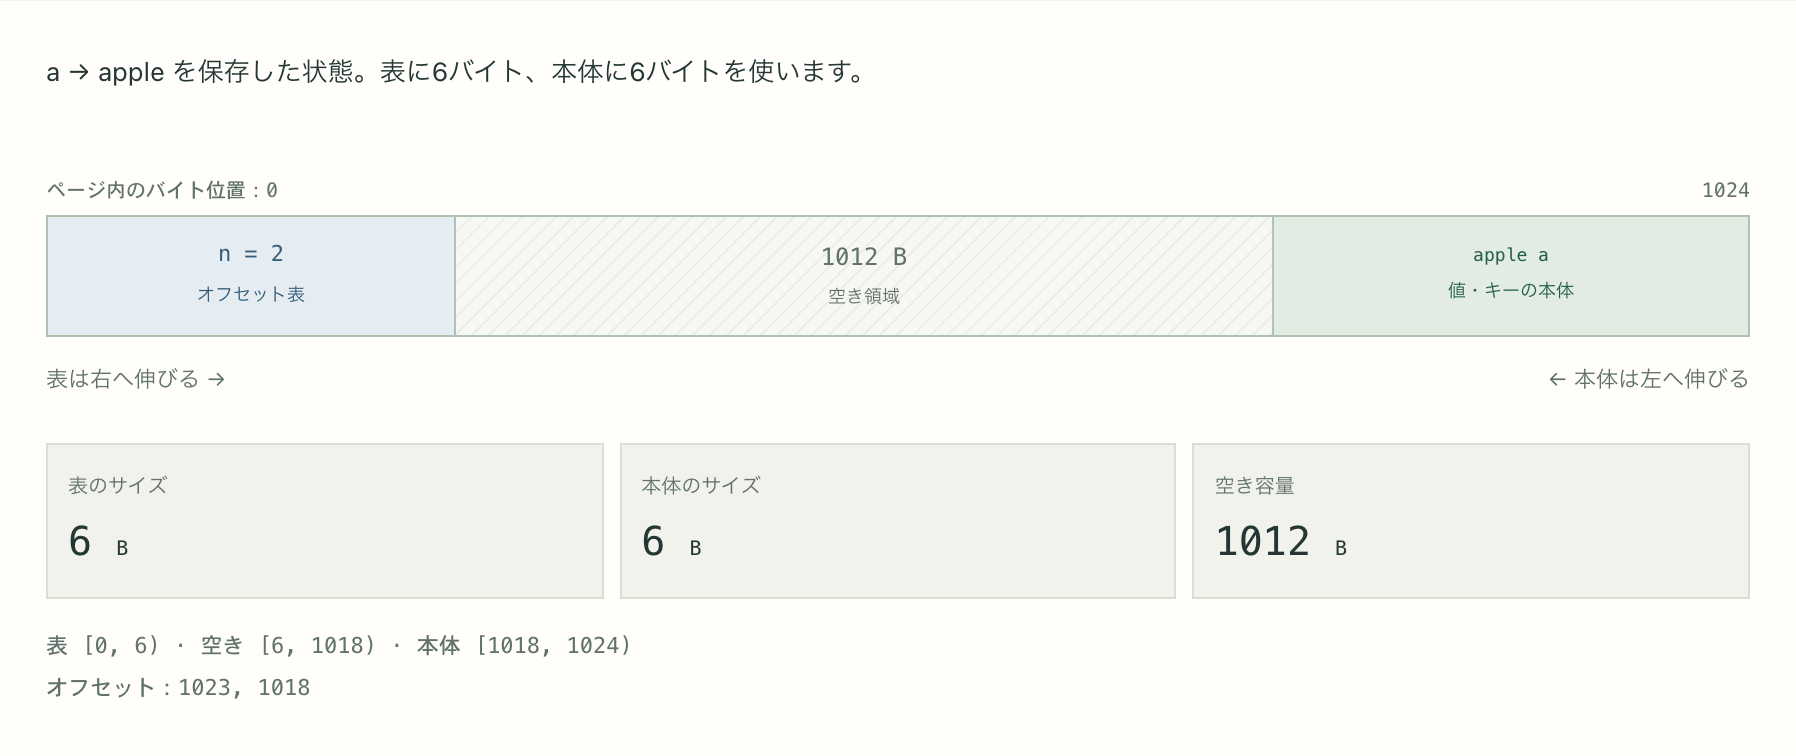
このバイト列だけでは、どこまでが値でどこからがキーか分かりません。そこで、ページ先頭からの位置を表すオフセットを、先頭の表に保存します。
| 表の要素 | 内容 | 記録する数値 | 表を置く位置 |
|---|---|---|---|
0 | オフセットの個数 n | 2 | [0, 2) |
1 | キーの開始位置 | 1023 | [2, 4) |
2 | 値の開始位置 | 1018 | [4, 6) |
表を置く位置と、表に記録する位置は別
バイト範囲 [2, 4) に書くのはキー a ではなく、「キーは1023から始まる」という数値です。1ペアでオフセットは2個、個数も含めた表は6バイトです。
表は右へ、本体は左へ
ペアが増えると、先頭の表は後ろへ伸び、末尾の本体は前へ伸びます。二つが真ん中の空きを使っていく構造です。これは、データ本体と、その位置を記録する表を同じページに収める「スロット化ページ」の基本的な考え方です。
このように、位置情報とデータ本体を空き領域の両側から増やす配置は、PostgreSQLのテーブルページにも見られます。SDBMの小さなページを読むことは、ほかのデータベースの内部構造を理解する足掛かりにもなります。
1件を保存したページ
3件を保存したページ
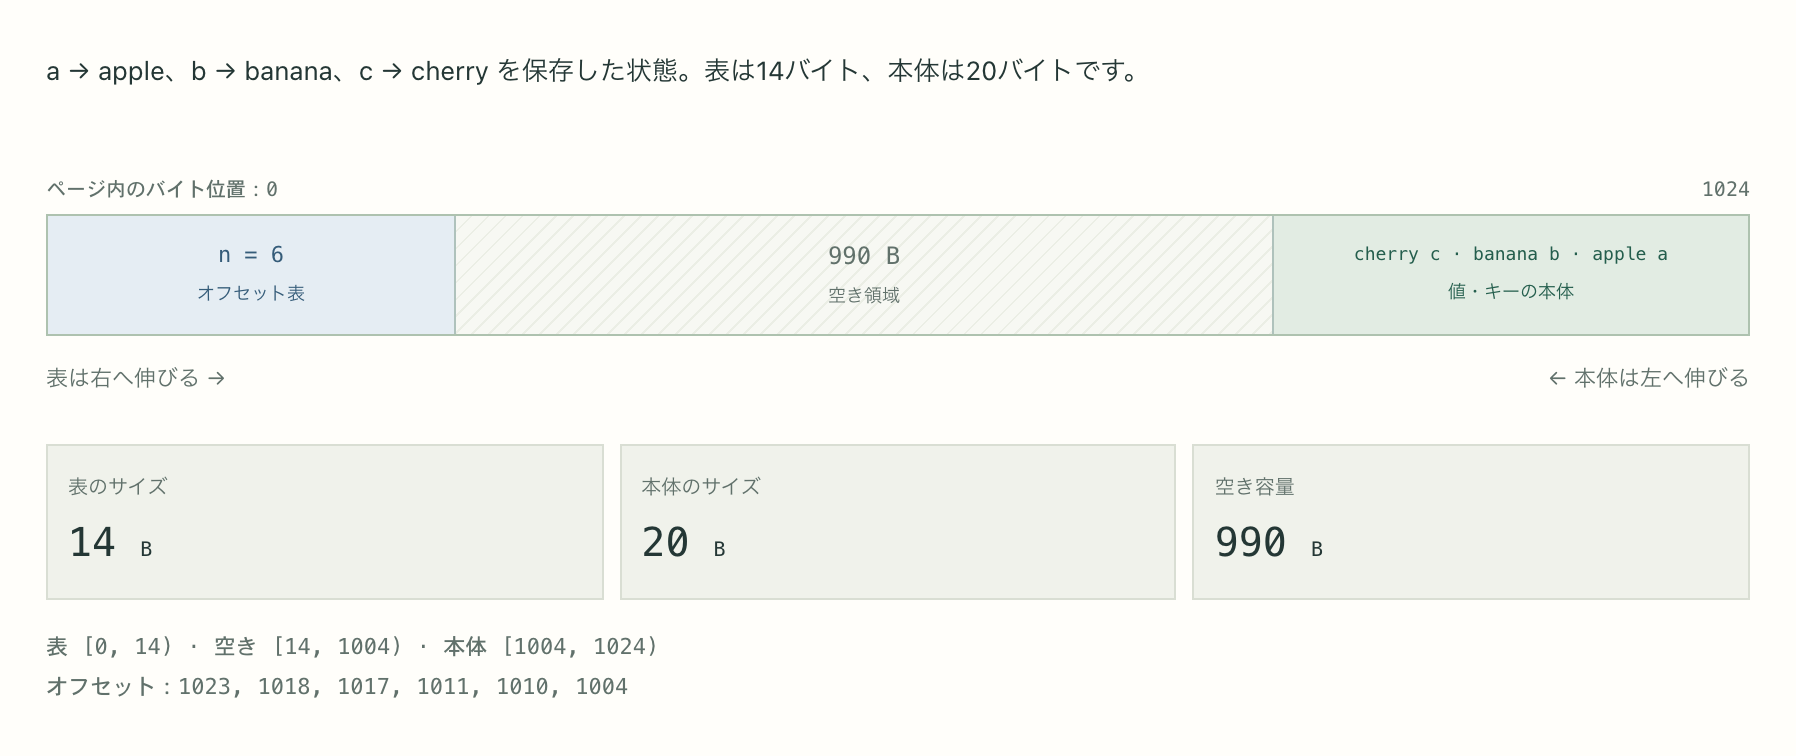
3件を入れると、b のキーは1017、値は1011から、c のキーは1010、値は1004から始まります。オフセット6個と個数の表は14バイト。本体は20バイトなので、空きは 1004 − 14 = 990 バイトです。
空き容量を確かめる
新しいペアを保存する前に、ページに十分な空きがあるかを確認します。この判定を担当するのが、Page 型の FitPair メソッドです。キーと値の合計サイズに、オフセット二つ分の4バイトを加え、ページの空き容量と比較します。
GO · FitPair 抜粋 pair.go ↗
func (p *Page) FitPair(need int) bool {
    n := int(p.getN())
    off := PBLKSIZ
    if n > 0 {
        off = int(p.getIno(n))
    }
    free := off - (n+1)*SHORTSIZE
    need += 2 * SHORTSIZE

    return need <= free
}
キーと値を保存し、位置を記録する
空きが足りれば、ペアを書き込む PutPair メソッドを呼びます。キーと値をページ末尾側の空き領域にコピーし、それぞれの開始位置を表に記録します。次のコードは、その処理の抜粋です。
GO · PutPair 抜粋 pair.go ↗
func (p *Page) PutPair(key Datum, val Datum) {
    n := int(p.getN())
    off := PBLKSIZ
    if n > 0 {
        off = int(p.getIno(n))
    }

    // キーを置き、その開始位置を表に記録する
    off -= key.Size()
    copy(p.buf[off:], key)
    p.setIno(n+1, uint16(off))

    // キーの手前に値を置き、その開始位置を表に記録する
    off -= val.Size()
    copy(p.buf[off:], val)
    p.setIno(n+2, uint16(off))

    // オフセットの個数を二つ増やす
    p.setN(uint16(n + 2))
}
コード中の p は操作するページです。表にオフセットを書き込む補助メソッドが setIno、オフセットの個数を更新する補助メソッドが setN です。key.Size() と val.Size() は、それぞれキーと値のバイト数を返します。
二つの境界があれば、長さは保存しなくてよい
ページ内から値を取得するのが、GetPair メソッドです。内部では、キーを探す補助メソッド seePair を呼び、ページ内のキーを順に比較します。見つかったキーの開始位置が表の要素 i にあるなら、次の要素 i+1 が値の開始位置。表の整数を読み取る補助メソッド getIno でこの二つの境界を読み、値を切り出します。
GO · GetPair メソッド全体 pair.go ↗
func (p *Page) GetPair(key Datum) Datum {
    n := int(p.getN())
    if n == 0 {
        return Nullitem
    }

    i := p.seePair(n, key)
    if i == 0 {
        return Nullitem
    }

    start := p.getIno(i + 1)
    end := p.getIno(i)

    val := Datum(p.buf[start:end])

    return val
}
ページが空の場合やキーが見つからない場合は、Nullitem を返します。キーが見つかった場合、a の値は p.buf[1018:1023] から apple(5バイト)、b の値は p.buf[1011:1017] から banana(6バイト)として取り出します。
冒頭の使用例でキーと値に使った Datum は、[]byte に名前を付けた型です。Datum(p.buf[start:end]) は型の変換であり、バイト列のコピーは行いません。
長さを別に保存したり、文字列の終端を示すゼロバイトを探したりする必要はありません。キーの長さも、前のペアの値の開始位置(最初のペアなら1024)との差で求められます。
GetPair が呼ぶ seePair は、ページ内のキーを順に比較します。n はオフセットの個数です。表を二要素ずつ進み、一致するキーのオフセットが入った要素番号を返します。
GO · seePair メソッド全体 pair.go ↗
func (p *Page) seePair(n int, key []byte) int {
    off := PBLKSIZ
    for i := 1; i < n; i += 2 {
        cur := p.getIno(i)
        if len(key) == off-int(cur) && bytes.Equal(key, p.buf[cur:cur+uint16(len(key))]) {
            return i
        }
        off = int(p.getIno(i + 1))
    }
    return 0
}
off は最初のペアなら1024、それ以降は前のペアの値の開始位置です。そこから現在のキーの開始位置 cur を引くと、キーの長さが分かります。長さが一致し、bytes.Equal で内容も一致したら i を返し、最後まで見つからなければ0を返します。
整数を保存するバイト順:little-endian
表の整数一つは2バイトで保存します。複数のバイトで一つの整数を表すには、バイトの並び順を決める必要があります。このGo実装では、little-endian環境のC版SDBMとファイル形式を合わせるため、下位のバイトを先に置きます。例えば1023は16進数で 0x03ff なので、保存する並びは ff 03 です。
表に整数を書き込む setIno メソッドと、読み取る getIno メソッドは、どちらも binary.LittleEndian を使います。同じ並び順で書き、同じ並び順で読むことで、保存した位置情報を元の整数に戻せます。
GO · setIno / getIno メソッド全体 pair.go ↗
func (p *Page) setIno(i int, val uint16) {
    binary.LittleEndian.PutUint16(p.buf[i*2:], val)
}

func (p *Page) getIno(i int) uint16 {
    return binary.LittleEndian.Uint16(p.buf[i*2 : i*2+2])
}
getIno(1) はバイト位置2〜3の ff 03 を読み、1023を返します。引数の1は、表の要素番号です。
オフセットの個数 n | キーの開始位置 | 値の開始位置 |
|---|---|---|
02 00 | ff 03 | fa 03 |
| 2 | 1023 | 1018 |
削除によるデータの移動と、取得済みの値への影響
a, b, c を保存したページから、途中の b → banana を削除します。空く本体は7バイト。ページ内のペアを削除する DelPair メソッドは、後から入れた c → cherry を7バイトだけ高い位置へ移し、穴を詰めます。
DelPair は本体とオフセットを詰め直す
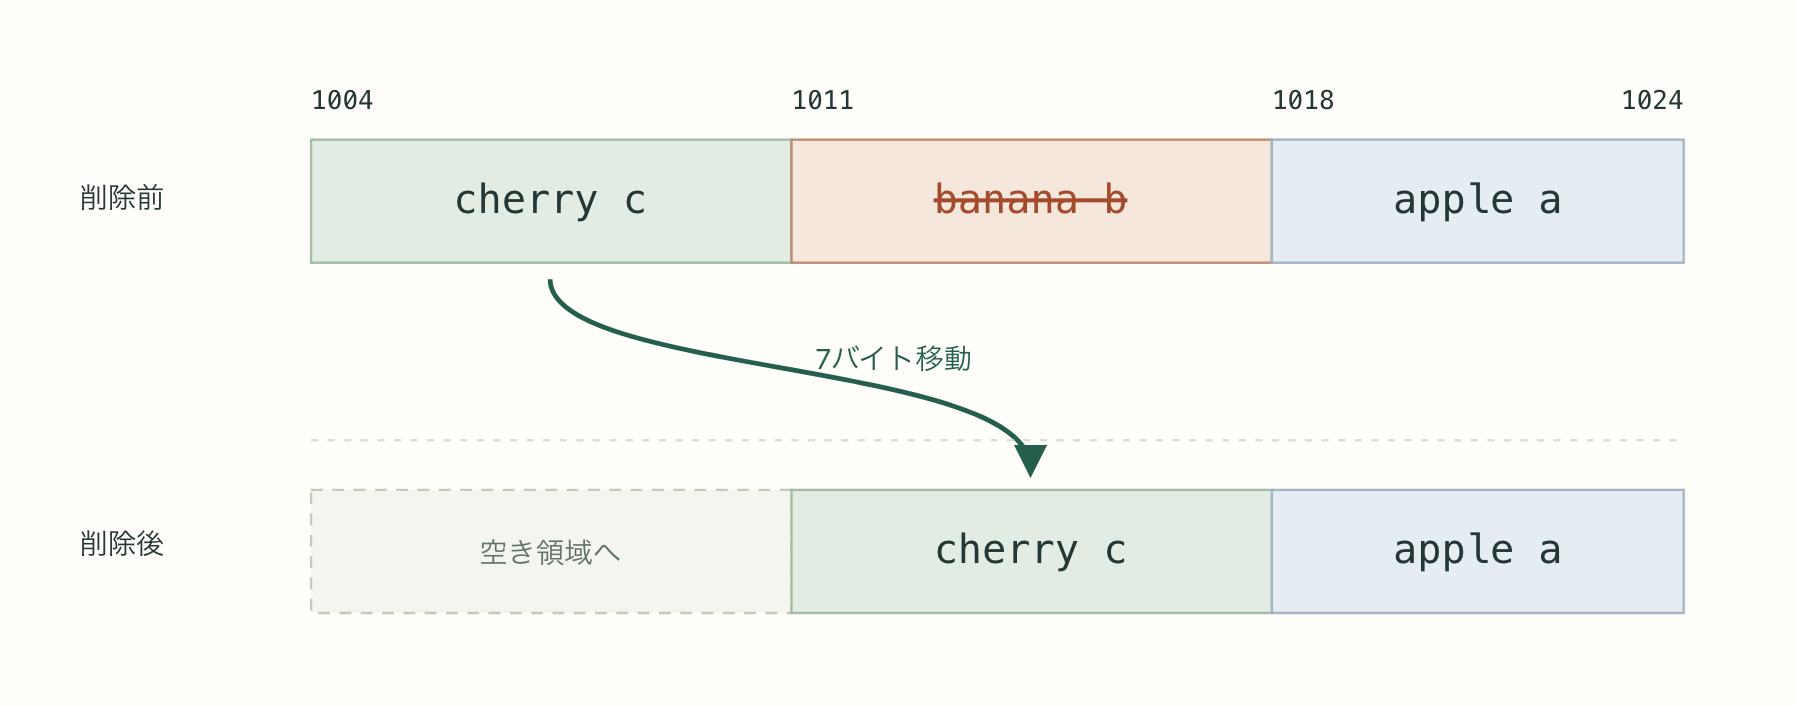
本体の移動には、Goの組み込み関数 copy を使います。移動するデータが、削除で空いた領域より大きい場合、コピー元とコピー先の範囲は一部重なります。Goの仕様では、copy はその場合でもコピー前の内容を正しくコピー先へ書き込めることが保証されているため、同じ配列の中でデータを詰め直せます。今回の図では、7バイトを隣の7バイトの領域へ移すので、二つの範囲は重なりません。
削除前の c の開始位置は、表の要素5・6に記録されています。本体を7バイト高い位置へ移したので、キーの開始位置は 1010 + 7 = 1017、値の開始位置は 1004 + 7 = 1011 になります。この二つを、b の開始位置が入っていた表の要素3・4へ書き込み、オフセットの個数を6から4へ減らします。
削除後の表は n=4、オフセットは 1023, 1018, 1017, 1011 になります。
削除前のオフセット表と空き容量
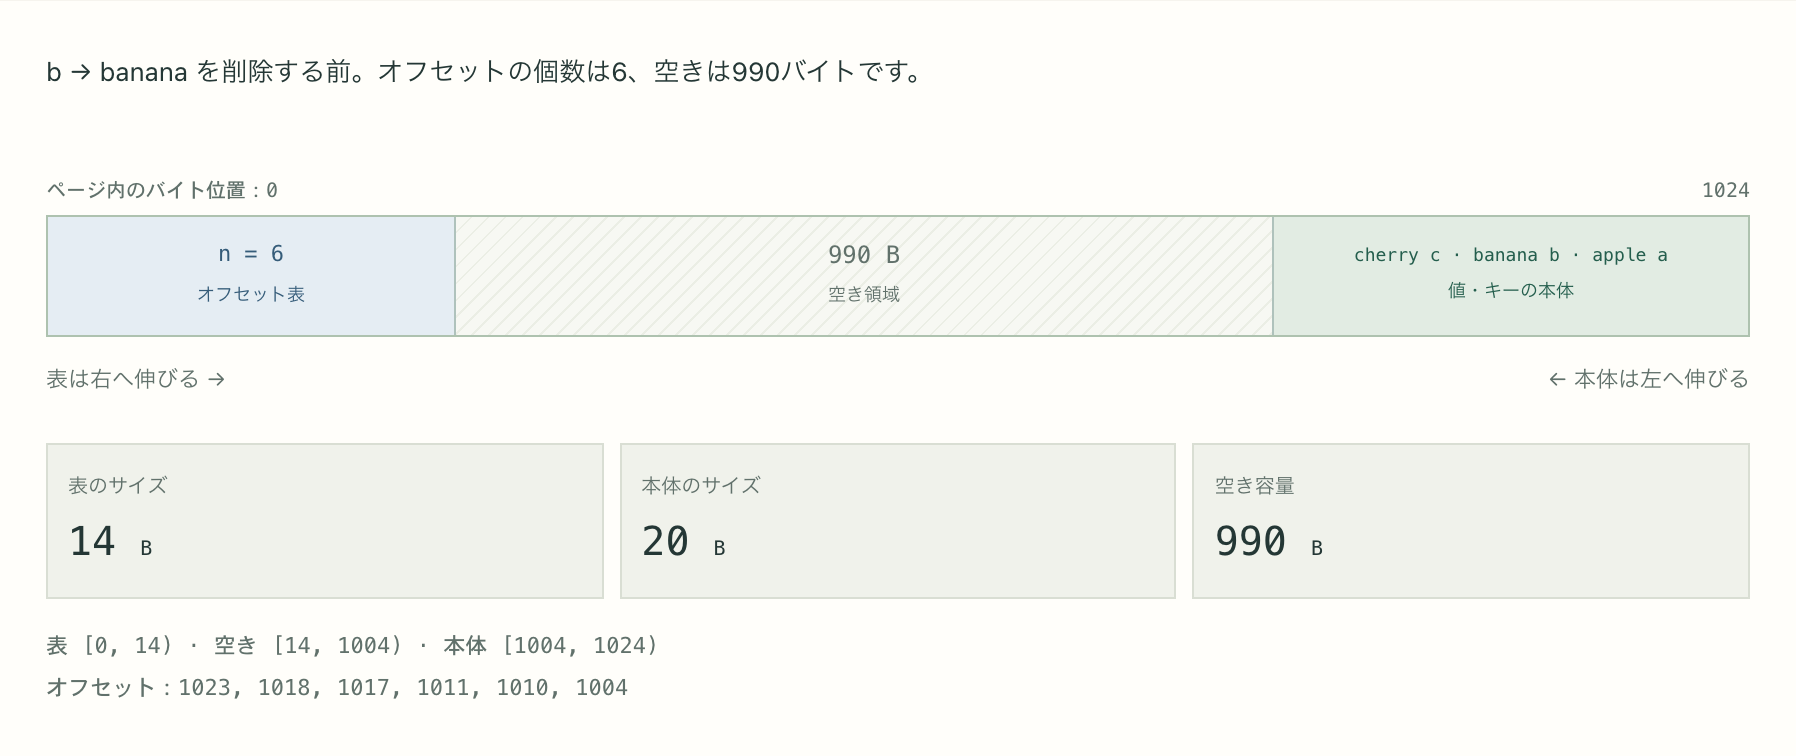
表の要素3・4には b の開始位置、要素5・6には c の開始位置が入っています。領域の幅は説明用に拡大しています。正確な範囲は図中の数値を参照してください。本体表示の空白・中点は区切りで、保存されるバイトではありません。
削除後のオフセット表と空き容量
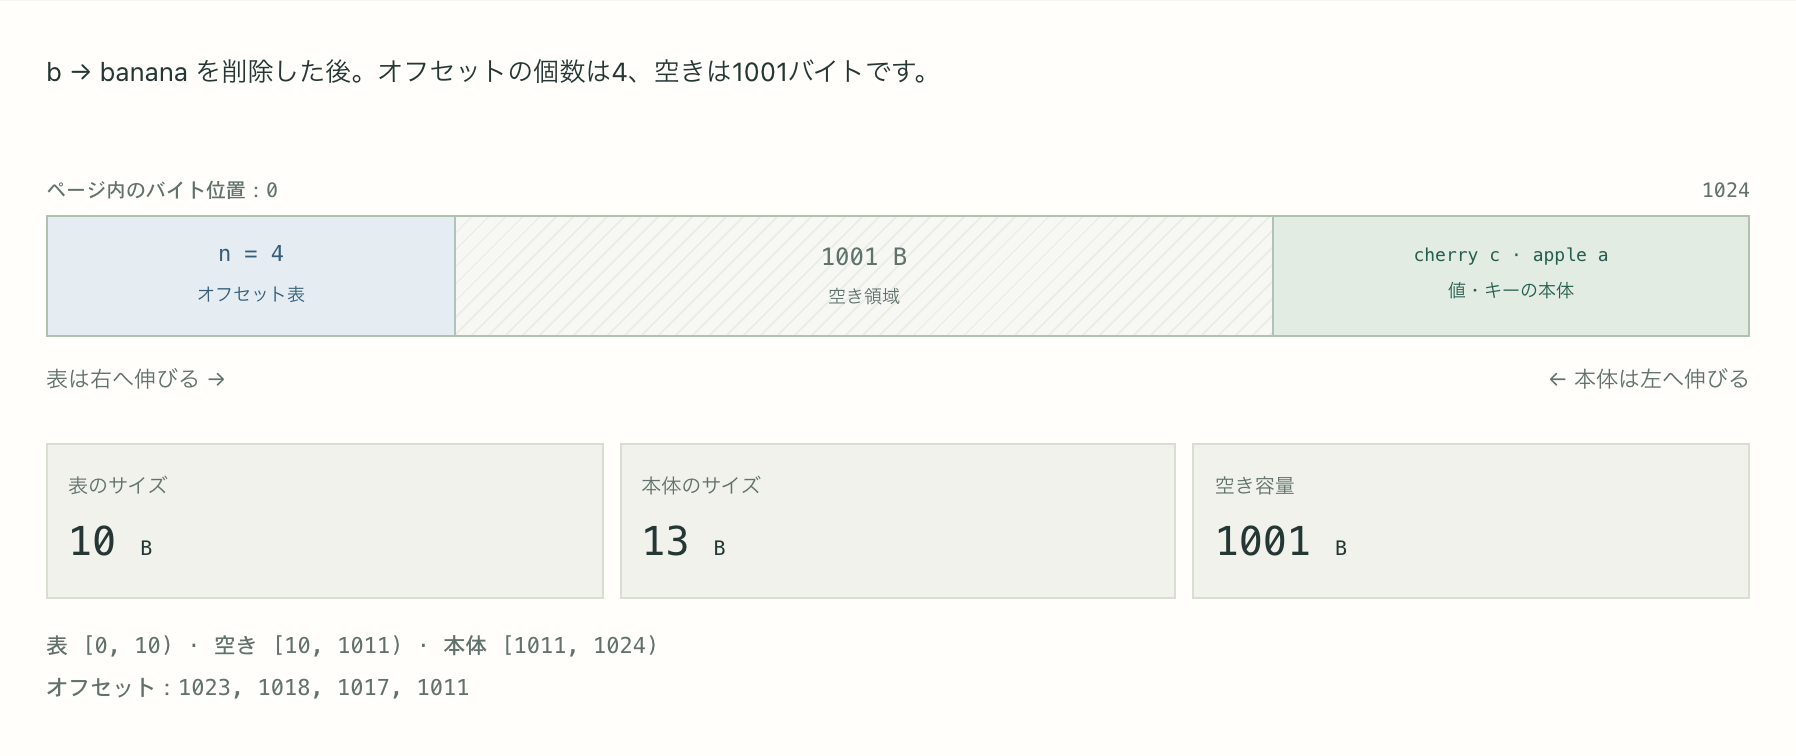
c のキーと値の開始位置に7を加え、表の要素3・4へ1017, 1011を書き込みます。表の有効範囲は [0, 14) から [0, 10) へ縮みます。領域の幅は説明用に拡大しています。正確な範囲は図中の数値を参照してください。本体表示の空白・中点は区切りで、保存されるバイトではありません。
なお、表の最後にあるペアを削除する場合は、移すべき後続のペアがありません。この場合の DelPair メソッドは本体を動かさず、オフセットの個数を2減らすだけです。
ここまでの処理を DelPair の実装で確認します。n はオフセットの個数、i は削除するキーのオフセットが入った表の要素番号です。
GO · DelPair 抜粋 pair.go ↗
func (p *Page) DelPair(key Datum) bool {
    n := int(p.getN())
    if n == 0 {
        return false
    }

    i := p.seePair(n, key)
    if i == 0 {
        return false
    }
    // 表の最後のペアでなければ、本体とオフセットを詰め直す
    if i < n-1 {
        var dst int
        if i == 1 {
            dst = PBLKSIZ
        } else {
            dst = int(p.getIno(i - 1))
        }
        src := int(p.getIno(i + 1))
        zoo := dst - src
        // 後続のペアの本体を、削除するペアの領域へ移す
        m := int(p.getIno(i+1) - p.getIno(n))
        copy(p.buf[dst-m:dst], p.buf[src-m:src])
        // 表を二要素詰め、移動量 zoo を各オフセットに加える
        for i < n-1 {
            p.setIno(i, p.getIno(i+2)+uint16(zoo))
            i++
        }
    }
    // 有効なオフセットの個数を二つ減らす
    p.setN(p.getN() - 2)
    return true
}
今回の b の削除では、dst = 1018、src = 1011 なので、削除するペアのサイズ zoo は7バイトです。移す本体のサイズ m も7バイトで、copy は [1004, 1011) を [1011, 1018) へコピーします。
取得した値が、削除後に変わるのはなぜか
DBから値を取得する Fetch メソッドで、削除前に b の値を取り出しておきます。このときは banana ですが、b を削除した後に取得済みのスライスをもう一度読むと、cherry に変わっています。
これは、取得時に値のバイト列を新しい領域へコピーしていないためです。DBは、読み込んだページをメモリ上の配列に保持しています。Fetch メソッドが返すのは、その配列の一部を参照するスライスです。
先ほどの削除を、取得したスライスの側から追ってみます。
- 取得したスライスは、配列の
[1011, 1017)を参照しています。この範囲にはbananaが入っています。 bを削除すると、同じ配列の中でcherry cが移動し、[1011, 1017)にcherryが入ります。- スライスは同じ範囲を参照し続けるため、後で読むと
cherryが見えます。
参照する場所は同じで、その場所の中身が変わったということです。
そこで、取得したスライスをそのまま保持した場合と、バイト列をコピーして保持した場合を比べます。次のコードでは、value がDB内部の配列を参照するスライスです。bytes.Clone 関数で別の領域へコピーした saved は、その配列を共有しません。
GO · サンプルのスライス共有 main.go ↗
value, err := db.Fetch(sdbm.Datum("b"))
if err != nil { return err }
saved := bytes.Clone(value)

if err := remove(db, "b"); err != nil { return err }
fmt.Printf("  after Delete(b): borrowed=%q copied=%q\n", value, saved)
//   after Delete(b): borrowed="cherry" copied="banana"
上のコードは、サンプルの smallExample 関数からの抜粋です。remove は、DBからペアを削除する Delete メソッドを呼び、削除に成功したことを確認する補助関数です。
削除後、value からは cherry が見えますが、独立したバイト列を持つ saved は banana のままです。
別のDB操作をまたいで保持する値は、先にコピーする
削除による詰め直しのほか、別ページの読み込みでもDB内部の配列は再利用されます。取得時の内容を後でも使いたい場合は、次のDB操作に進む前に bytes.Clone でコピーしておきます。
この性質は、元のC版SDBMにもあります。C版も値のコピーを返すのではなく、内部のページバッファを指すポインタと長さを返します。Go版は、その参照をバイトスライスで表しています。どちらも、取得時の内容を後のDB操作をまたいで保持したい場合は、利用側でコピーする必要があります。これは内部バッファの再利用によってコピーを省く設計であり、取得結果の扱いを利用側が管理する必要があるということです。
満杯のページを、次のビットで分ける
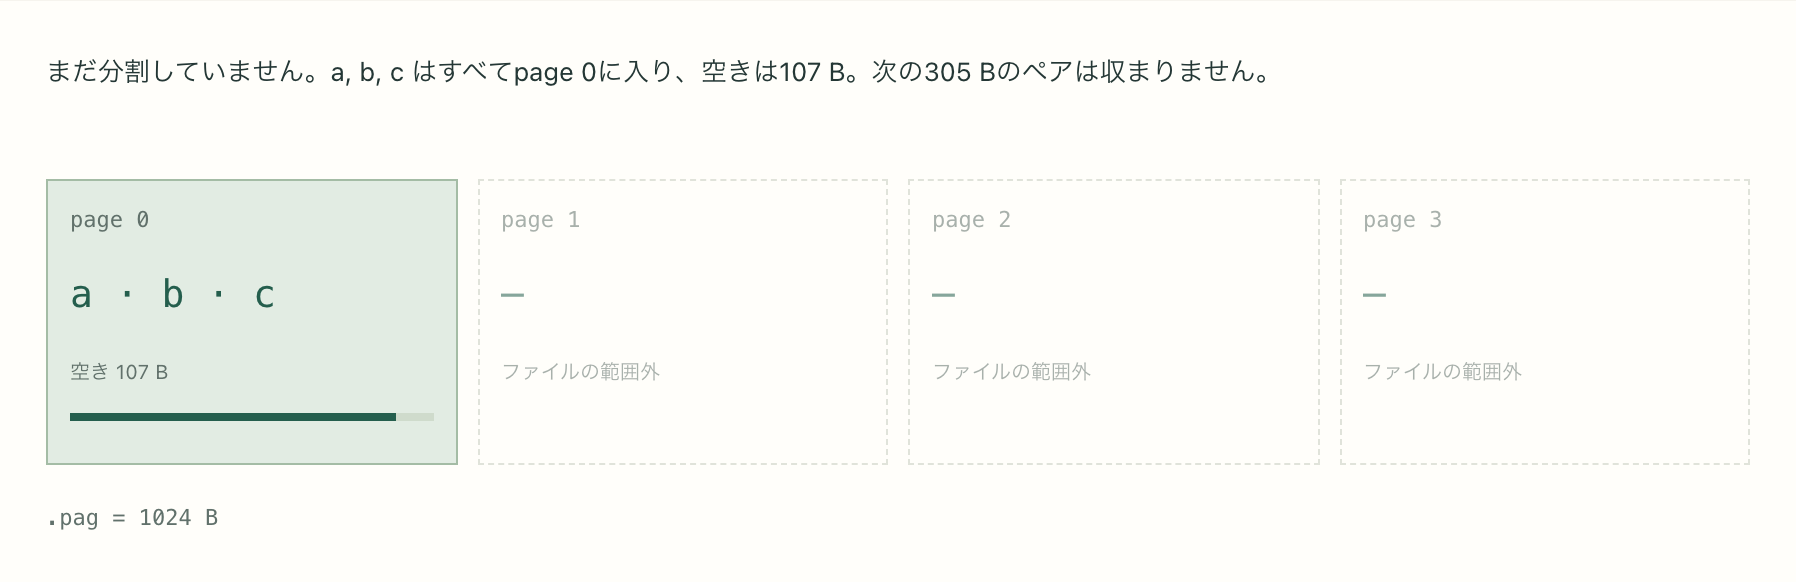
次は新しいDBを用意し、a, b, c, d, e, g の順に保存します。キーは各1バイト、値はキーと同じ文字を300回繰り返した300バイトです。ペアを大きくすると、ページの分割がすぐに見えてきます。
空きが足りず FitPair メソッドが false を返すと、ページを分割して空きを作る makeRoom メソッドへ進みます。
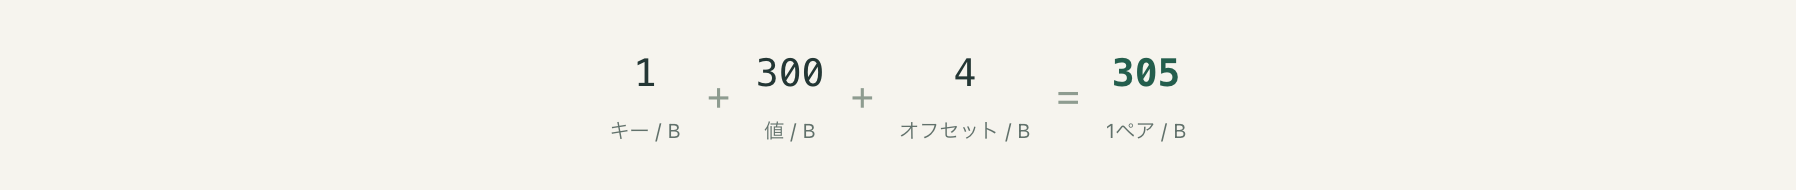
3件で917 B。4件目が入らない
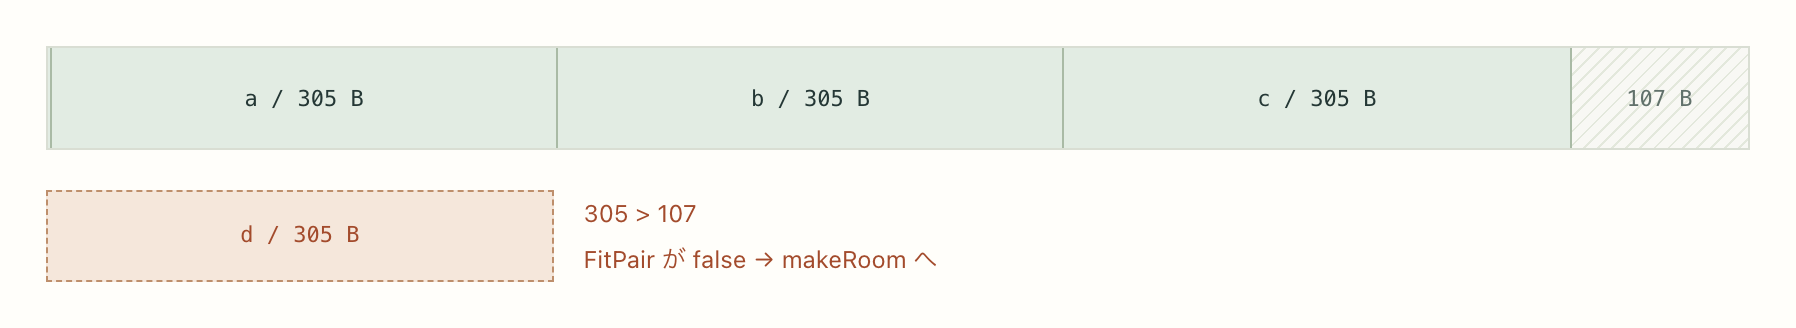
先頭の個数2バイトはページに一つだけ。使用量は 2 + 305 × 3 = 917 B です。この図はオフセット分も各ペアにまとめた容量の比較で、実際の配置順ではありません。
どのペアを新しいページへ移すか
ページを二つに分けるには、今あるペアを、元のページに残すものと新しいページへ移すものに振り分ける必要があります。また、後で値を探すときにも、キーから同じ保存先を選べなければなりません。
SDBMでは、この振り分けにキーから計算した整数である「ハッシュ」を使います。ハッシュをビット列として見て、まず一番右のビットが0なら元のページへ、1なら新しいページへ振り分けます。
一度振り分けると、同じページに入ったキーは、そこで調べたビットがすべて同じになります。そのページが再び満杯になっても、同じビットでは分けられません。そこで次の分割では、まだ使っていない左隣のビットを調べます。ハッシュ値はそのままで、調べるビットの位置を一つ左へ進めるということです。
このGo実装でハッシュを計算するのが、Hash 関数です。今回のキーは1文字のASCIIなので、計算結果は文字コードと同じになります。例えば a は97、b は98です。下位のビットを並べると、次のようになります。
| キー | ハッシュ | 下位3ビット | bit 0 | bit 1 |
|---|---|---|---|---|
a | 97 | 001 | 1 | 0 |
b | 98 | 010 | 0 | 1 |
c | 99 | 011 | 1 | 1 |
d | 100 | 100 | 0 | 0 |
e | 101 | 101 | 1 | 0 |
g | 103 | 111 | 1 | 1 |
1 << k はbit kだけを1にした整数です。hash & (1 << k) が0なら、そのビットは0。0以外なら1。この違いでペアを振り分けます。
ハッシュはどう計算する?
Hash 関数は、キーのバイトを先頭から一つずつ読み、直前までの計算結果を65599倍して、次のバイトの値を加えます。
GO · Hash 関数 hash.go ↗
func Hash(data []byte) int64 {
	var hash uint64
	for i := 0; i < len(data); i++ {
		hash = uint64(int64(int8(data[i]))) + 65599*hash
	}
	return int64(hash)
}
hash の初期値は0です。キーが "a" なら、ループは1回だけ実行されます。ASCIIの a は97なので、計算は 97 + 65599 × 0 = 97。これが、本文の表で a のハッシュが97になる理由です。
複数バイトのキーでは、この計算を繰り返します。例えば "ab" なら、a を読んで97になった後、b の98を加えて、98 + 65599 × 97 = 6,363,201 になります。
int8(data[i]) は、C版との互換性のために各バイトを符号付きの8ビット整数として扱う変換です。計算は uint64 で行い、下位64ビットを保持して、最後に int64 として返します。
最初はbit 0、同じページの再分割にはbit 1
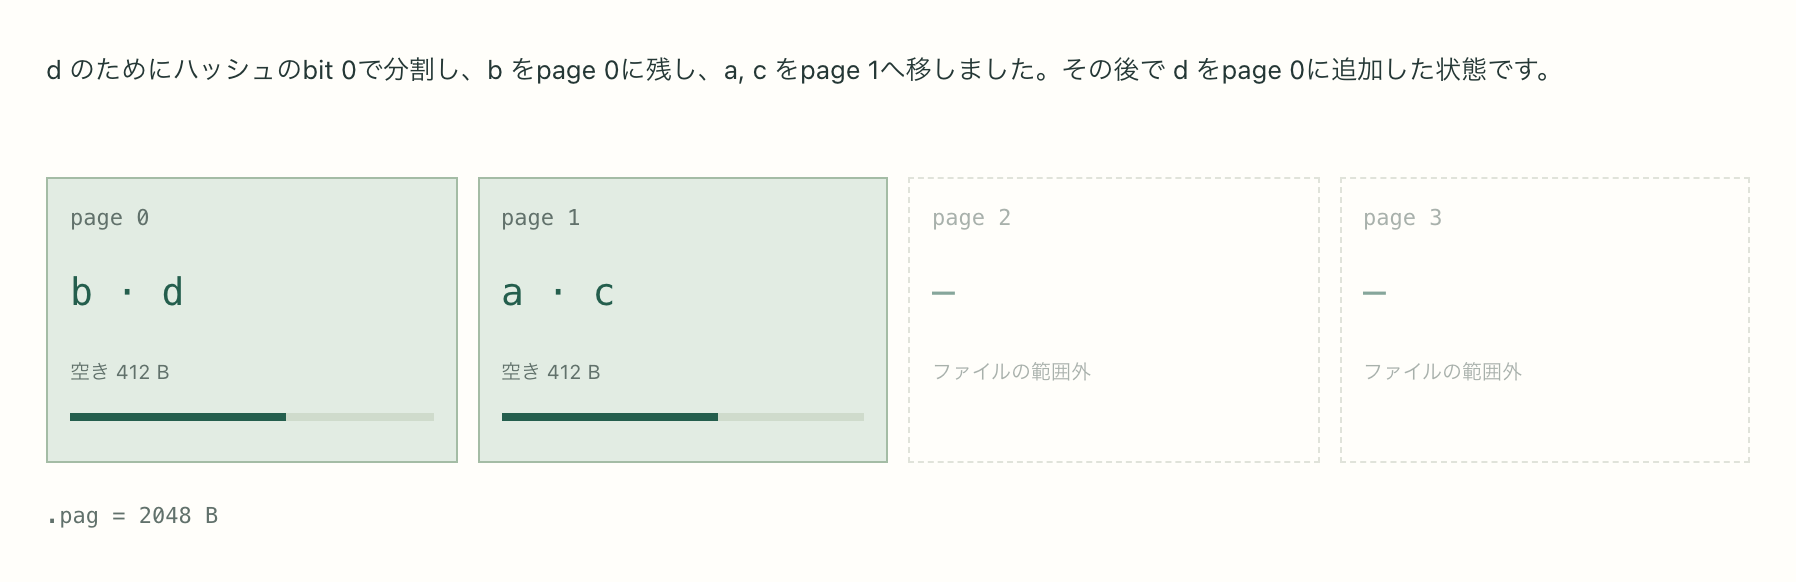
d を入れるとき、まず既存の a, b, c をbit 0で分けます。0の b はpage 0に残り、1の a, c はpage 1へ。その後で d をpage 0に入れます。
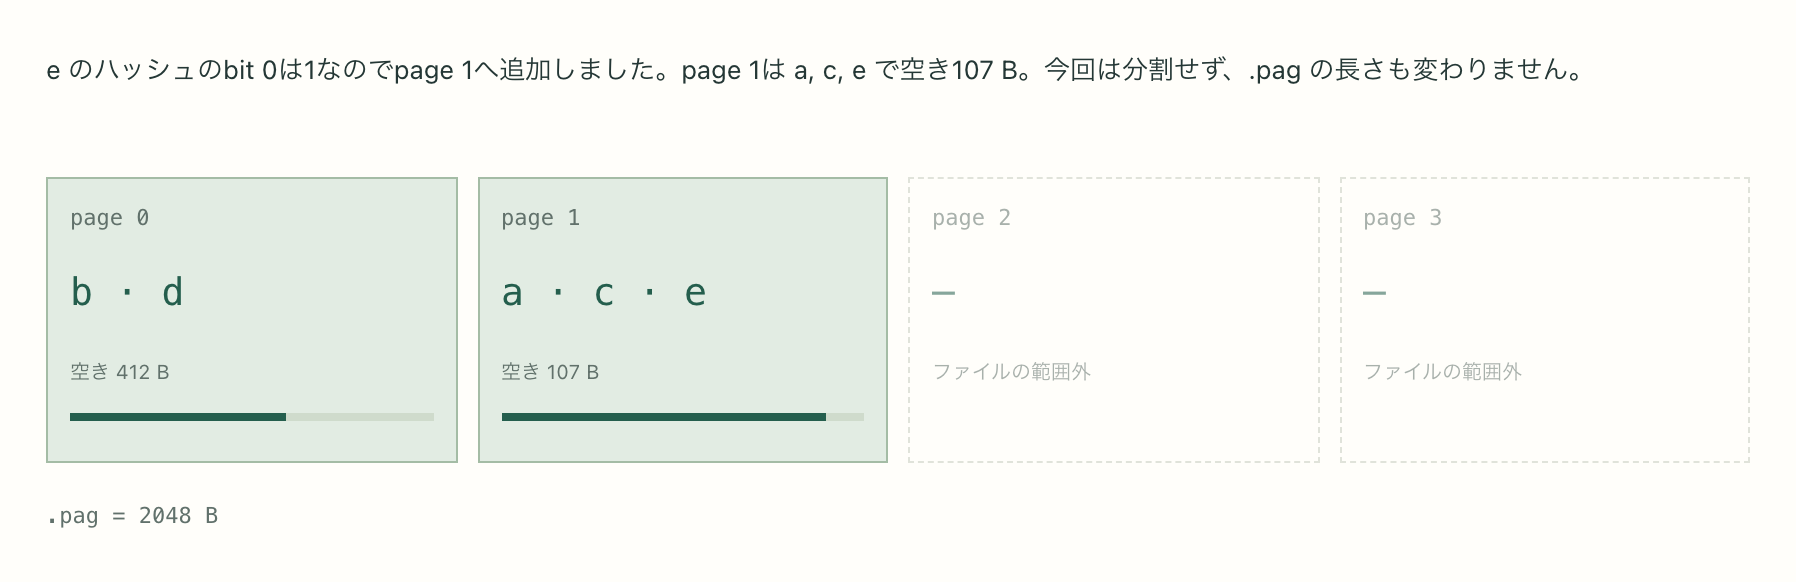
次の e はpage 1へ入り、そこが a, c, e でいっぱいになります。ここへ g を追加しようとしても、空きが足りません。
この4キーは、どれもbit 0が1です。bit 0で再び振り分けても、全員が同じ側へ行くため、空き不足は解消しません。そこで、今度はbit 1を使います。a, e は0、c, g は1なので、このビットなら二つに分けられます。
既存の a, e をpage 1に残し、c を新しいpage 3へ移します。その後で、g をpage 3に追加します。
新しいページに3という番号が付く理由は、後の章で説明します。ここでは、bit 1が0のペアを元のページに残し、1のペアを新しいページへ移す動きを追います。
次のビットが必ず異なるとは限りません。同じ側に偏ってまだ収まらなければ、さらに次のビットで分割を試します。この処理の回数には上限があり、後の章で説明します。
a, b, c の保存後
d の挿入後
e の挿入後
g の挿入後
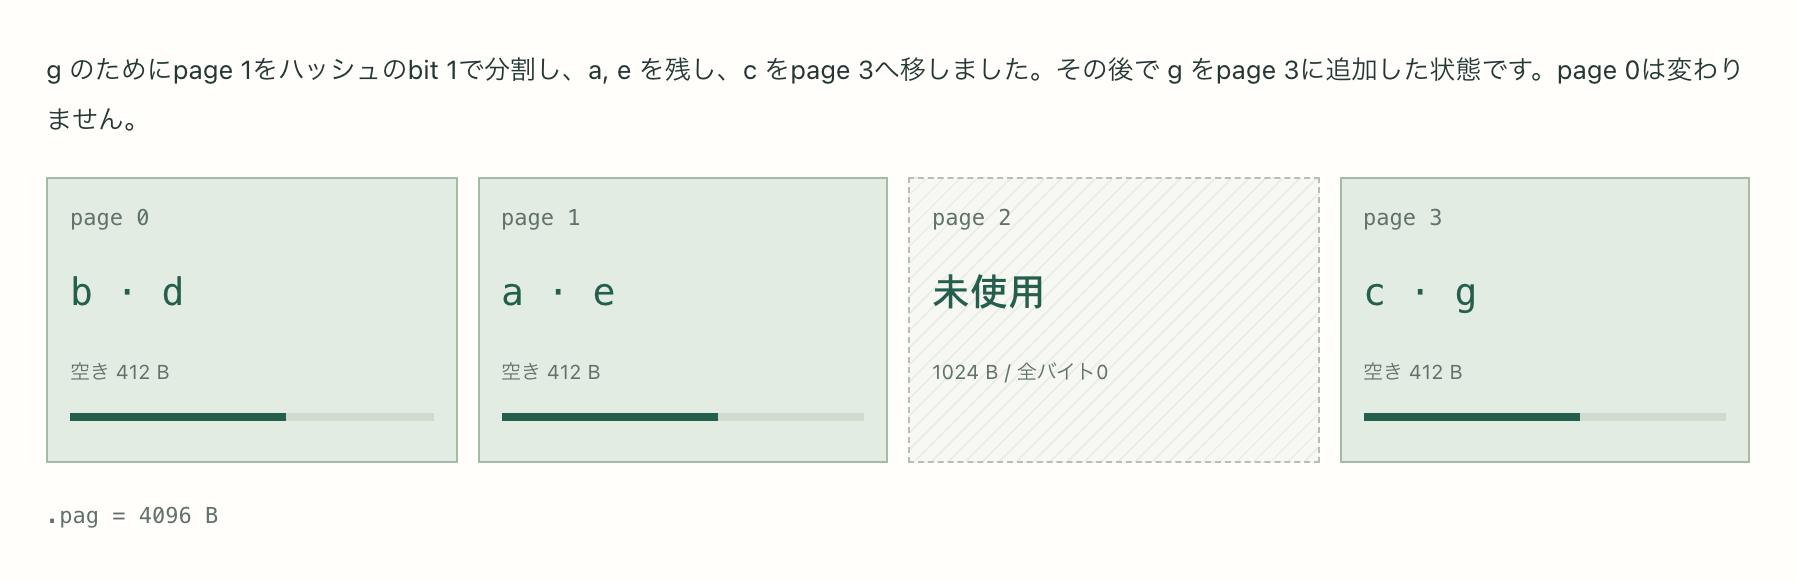
page 2はファイル内にありますが、ペアを保存していない未使用の領域です。
| 追加後 | page 0 | page 1 | page 2 | page 3 | .pag |
|---|---|---|---|---|---|
a,b,c | a,b,c | — | — | — | 1024 B |
d | b,d | a,c | — | — | 2048 B |
e | b,d | a,c,e | — | — | 2048 B |
g | b,d | a,e | 未使用 | c,g | 4096 B |
ページを分割した記録は .dir に保存されます。次章では、その記録を使って検索先を選ぶ仕組みを見ていきます。
makeRoom メソッドの内部で、ページ内のペアを二つのページへ振り分けるのが SplPage メソッドです。その中心も、小さな条件分岐です。元ページを一時退避し、元ページと新ページを空にしてから、各ペアを PutPair メソッドで詰め直します。
GO · SplPage 抜粋 pair.go ↗
func (p *Page) SplPage(newPag *Page, sbit int64) {
    var (
        key, val Datum
        cur      Page
    )
    off := PBLKSIZ

    copy(cur.buf[:], p.buf[:])
    copy(p.buf[:], make([]byte, PBLKSIZ))
    copy(newPag.buf[:], make([]byte, PBLKSIZ))

    n := int(cur.getIno(0))
    for i := 1; n > 0; i += 2 {
        keyOff := int(cur.getIno(i))
        valOff := int(cur.getIno(i + 1))

        key = cur.buf[keyOff:off]
        val = cur.buf[valOff:keyOff]

        // sbit が1のペアは新ページへ、0のペアは元ページへ詰め直す
        if exHash(key)&sbit != 0 {
            newPag.PutPair(key, val)
        } else {
            p.PutPair(key, val)
        }

        off = valOff
        n -= 2
    }

}
cur に元ページを退避するため、元ページを空にした後もペアを読み出せます。sbit は最初の分割では1(bit 0)、同じ側の再分割では2(bit 1)です。各ペアのキーと値を境界から切り出し、PutPair で保存先のページへ詰め直します。デバッグ出力を省略し、コメントを日本語にしています。
exHash は、Hash 関数を呼ぶ補助関数です。a と c はハッシュ全体が異なっていても、bit 0が同じなので最初は同居します。ページ内ではキーの比較で区別し、空きが足りなくなったときに次のビットを使う。これが、必要に応じて保存先を増やす動的ハッシュ法です。
検索では、ハッシュを何ビット使うのか
ここからは、6件の挿入が終わったDBから値を探します。前章では、最初にbit 0で分割し、その後でbit 0が1の側だけをbit 1でさらに分割しました。その結果、page 0に b, d、page 1に a, e、page 3に c, g が入っています。
前章の分割を振り返ると、b の保存先はハッシュのbit 0だけで決まりました。一方、c の保存先を決めるには、bit 0で振り分けた後、さらにbit 1を調べました。検索するときにも、この違いを再現する必要があります。
では、b はbit 0で止まり、c はbit 1まで調べると、どうすれば分かるのでしょうか。その判断に使うのが、分割の記録を保存した .dir です。
「分かれたか」を、1ビットで覚える
前章の分割を、検索時の判断としてたどってみます。まずハッシュのbit 0で二つに分かれます。0の側は、それ以上分割していないので、そこで止まります。1の側はもう一度分割したので、続けてbit 1を調べます。
この判断のつながりを木として表します。木の中で、さらに分岐するかどうかを判断する位置を節点、出発点を根と呼びます。.dir は節点ごとに1ビットを使い、分割済みでさらに分岐するなら1、未分割でそこで止まるなら0を記録します。
分岐する場所は1、止まる場所は0
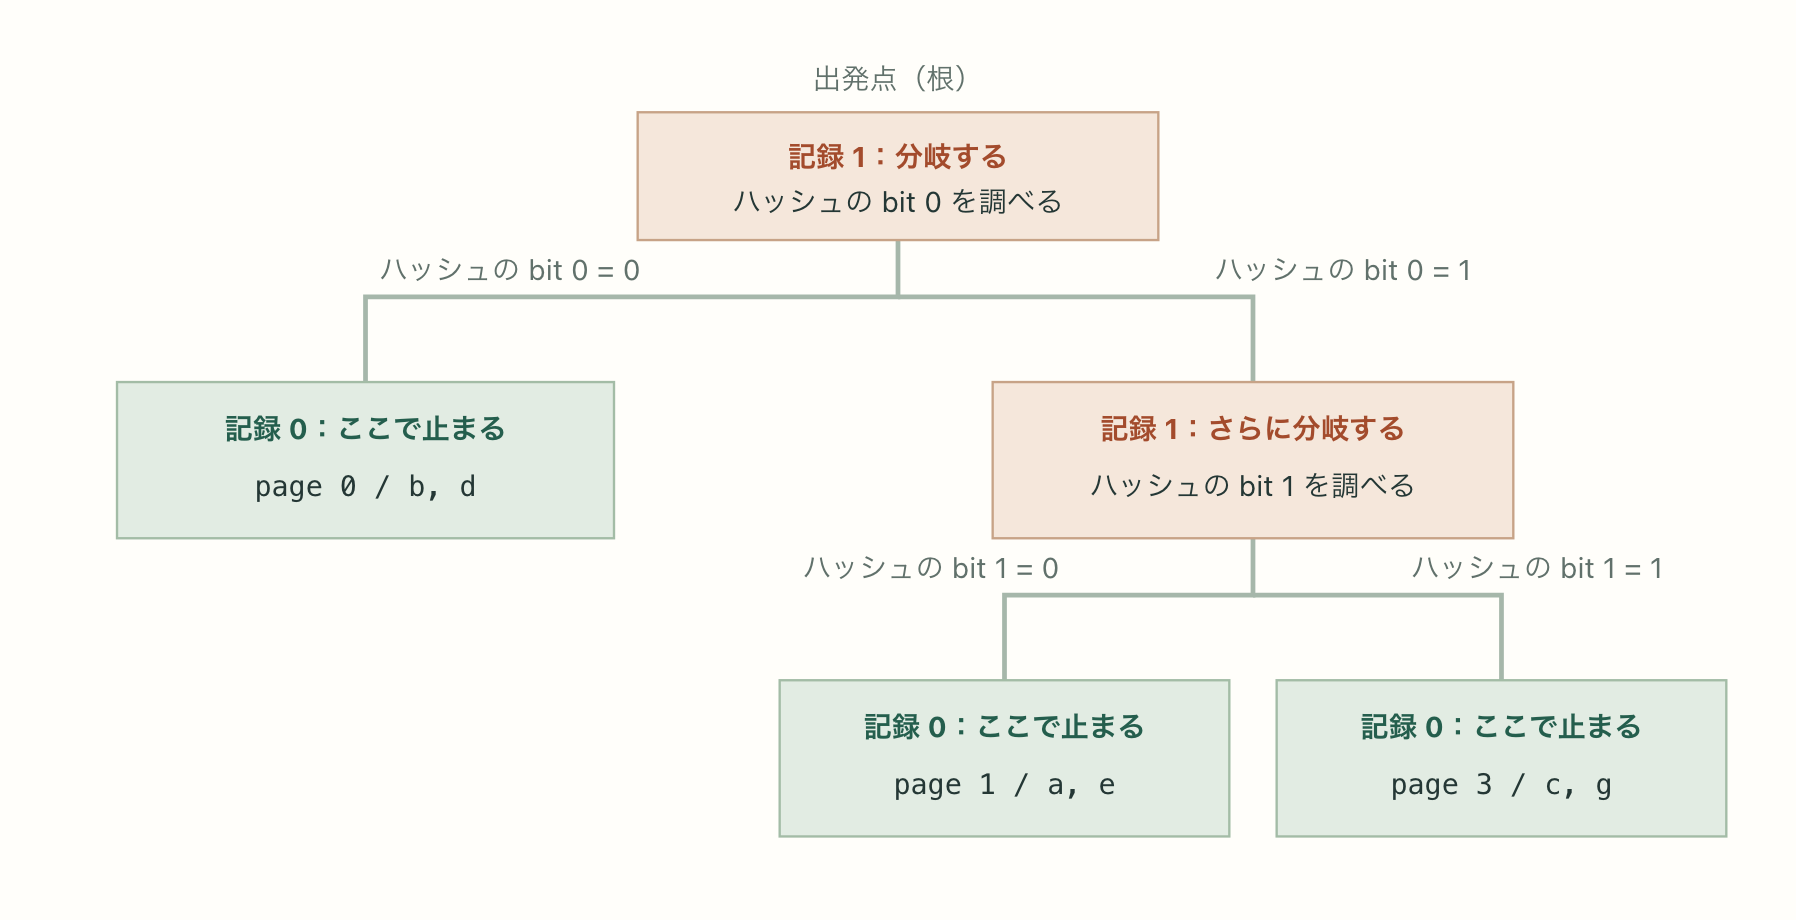
箱の「記録」は .dir に保存する1ビットです。線に添えた0・1は、進む方向を選ぶハッシュのビットです。左側は1回、右側は2回の分岐で止まります。図の page 0・page 1・page 3 は、前章でペアを保存した .pag 内のページです。各ページ名の横に、そのページに入っているキーを示しています。
節点に番号を付け、記録するビットを決める
どの節点の記録かを区別するため、各節点に番号を付けます。根は0。節点 i の左の子は 2*i + 1、右の子は 2*i + 2 とします。根の左は1、右は2で、節点2の左は5、右は6です。
節点番号は、そのまま .dir 内のビットの位置に対応します。節点0の記録はbit 0、節点2の記録はbit 2です。これは分岐の記録を読むための番号であり、.pag のページ番号とは別です。
節点の番号と、記録するビットの位置をそろえる
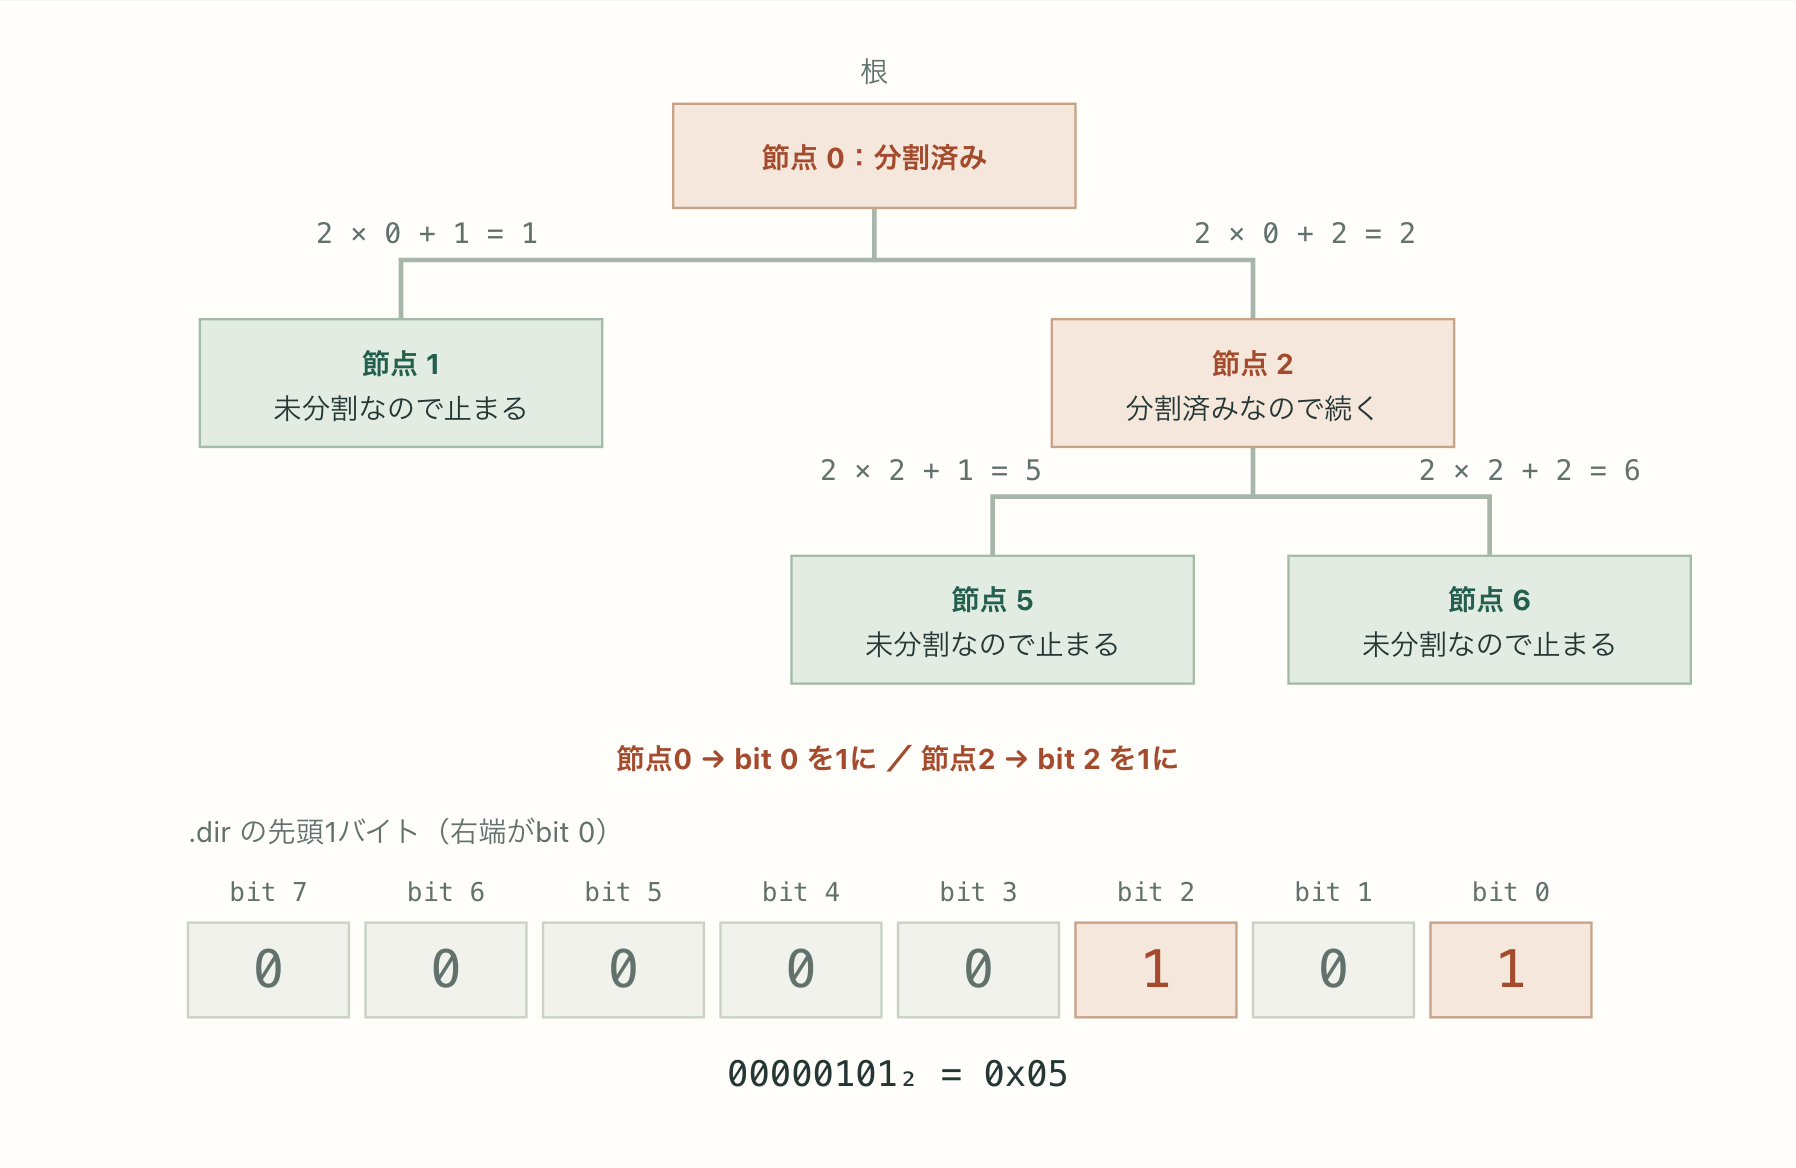
オレンジの節点0・2は分割済みなので、.dir の同じ番号のビットを1にします。節点1は未分割のため、その子に当たる節点3・4へは進みません。図に現れない位置も含め、分割の記録がないビットは0です。ここでの番号は節点とビットの対応を表し、ページ番号は示していません。
最初の分割で根の節点0を1にすると、先頭バイトは 00000001 = 0x01 になります。次に右側を分割して節点2も1にすると、00000101 = 0x05 になります。左側の節点1は未分割なので0です。節点5・6も、それ以上分割していないので0のままです。
| 段階 | 分割済みとして記録する節点 | .dir の先頭1バイト |
|---|---|---|
| 最初の分割後(d を追加) | 節点0 | 00000001 = 0x01 |
| 右側をさらに分割した後(g を追加) | 節点0・2 | 00000101 = 0x05 |
分岐の記録を読み、ハッシュで進む方向を選ぶ
検索は根の節点0から始め、次の手順を繰り返します。
- 節点番号と同じ位置にある
.dirのビットを読みます。例えば、節点0ならbit 0、節点2ならbit 2です。ビットが0なら、その節点で分岐を終えます。 - ビットが1なら、キーのハッシュの次のビットを読みます。最初はbit 0で、分岐するたびにbit 1、bit 2と進めます。
- ハッシュのビットが0なら左の子、1なら右の子へ進み、その子の節点番号を使って手順1に戻ります。
二つのビットは、役割が違う。.dir のビットは「ここで分岐するか」。キーのハッシュのビットは「左右どちらへ進むか」。まず分岐が必要かを確認し、必要な場合だけハッシュの次のビットを使います。
分岐の確認 → 方向の選択 → 移動先で確認
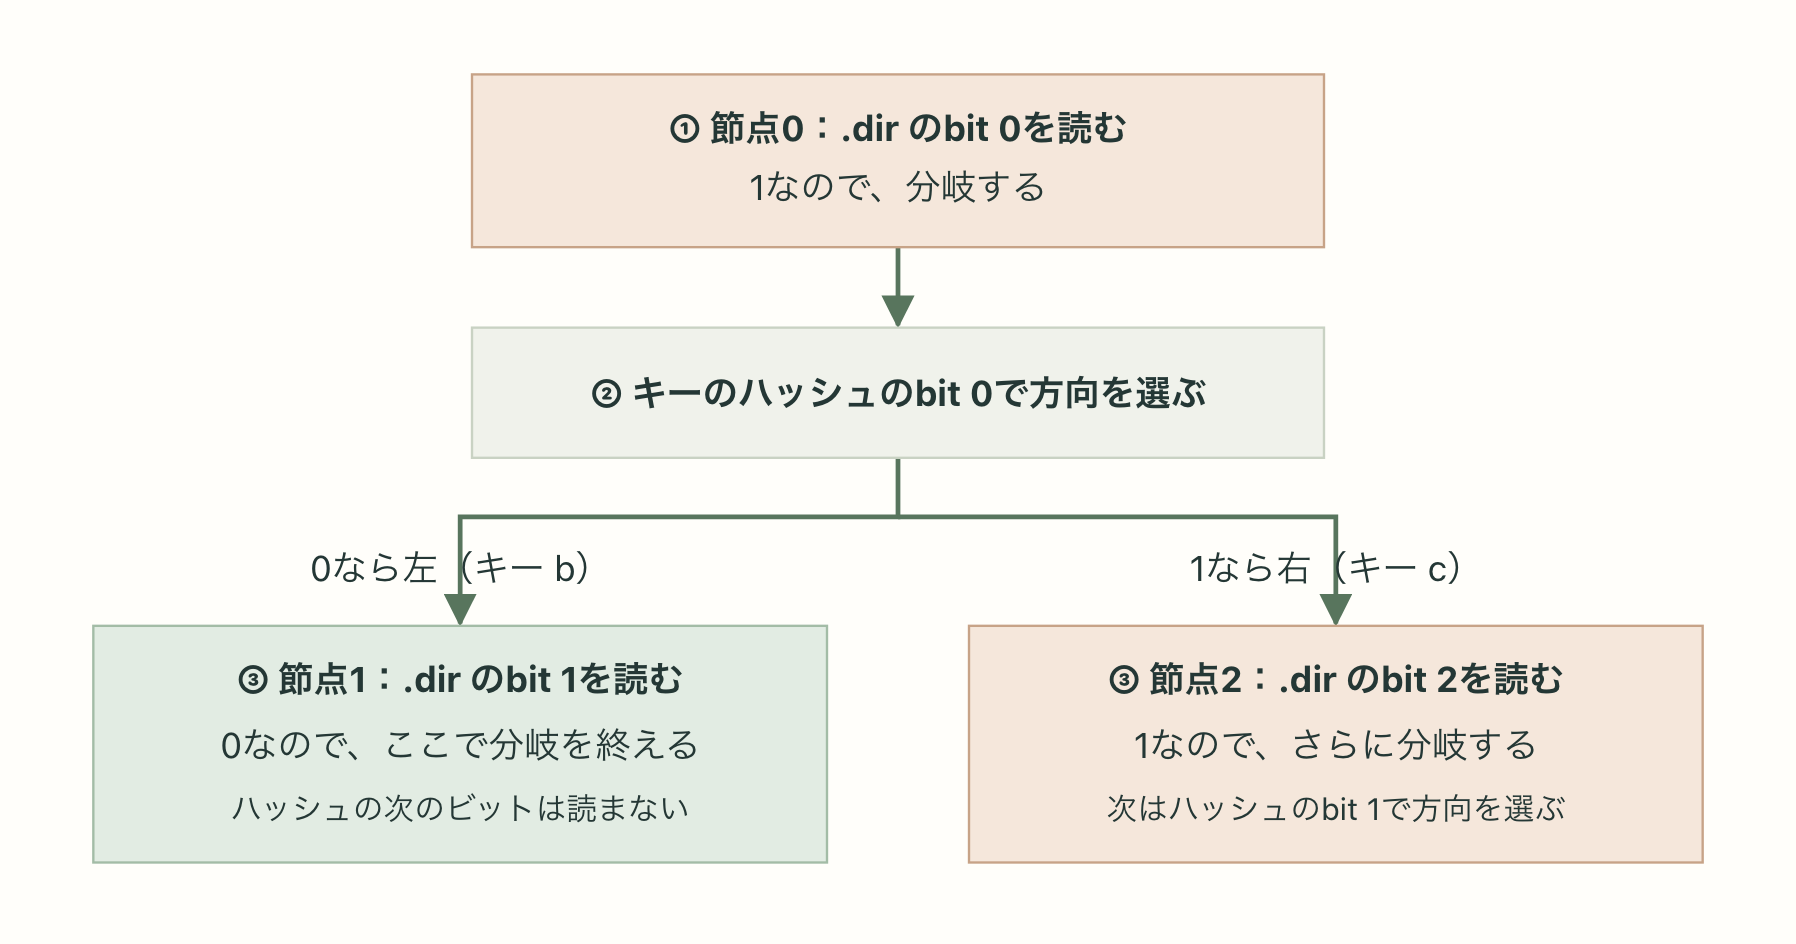
.dir は節点番号に対応するビットを読みます。キーのハッシュは、分岐するたびにbit 0、bit 1、…の順に読みます。
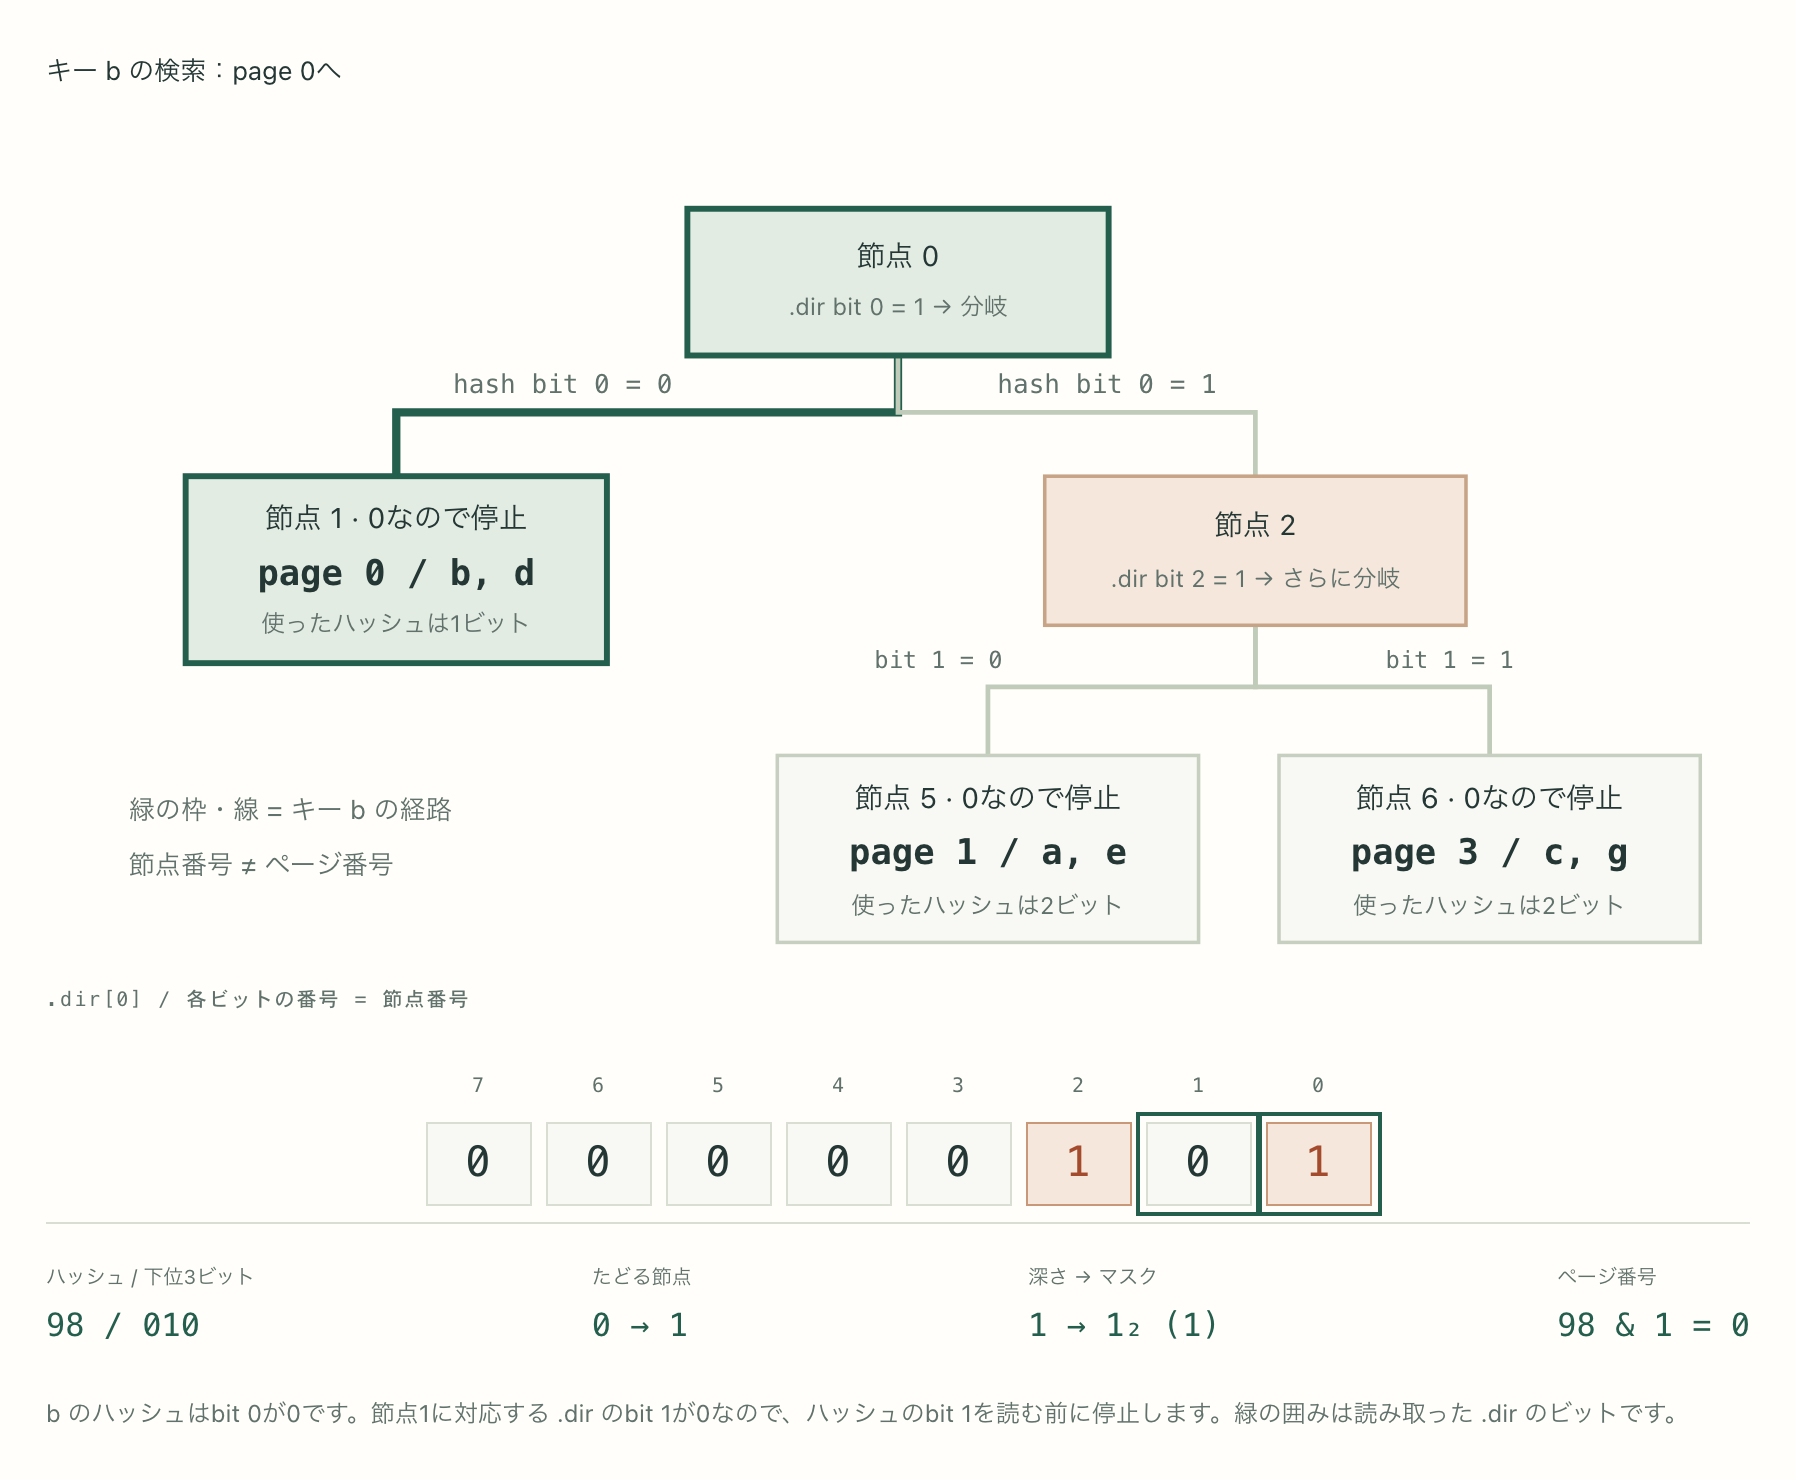
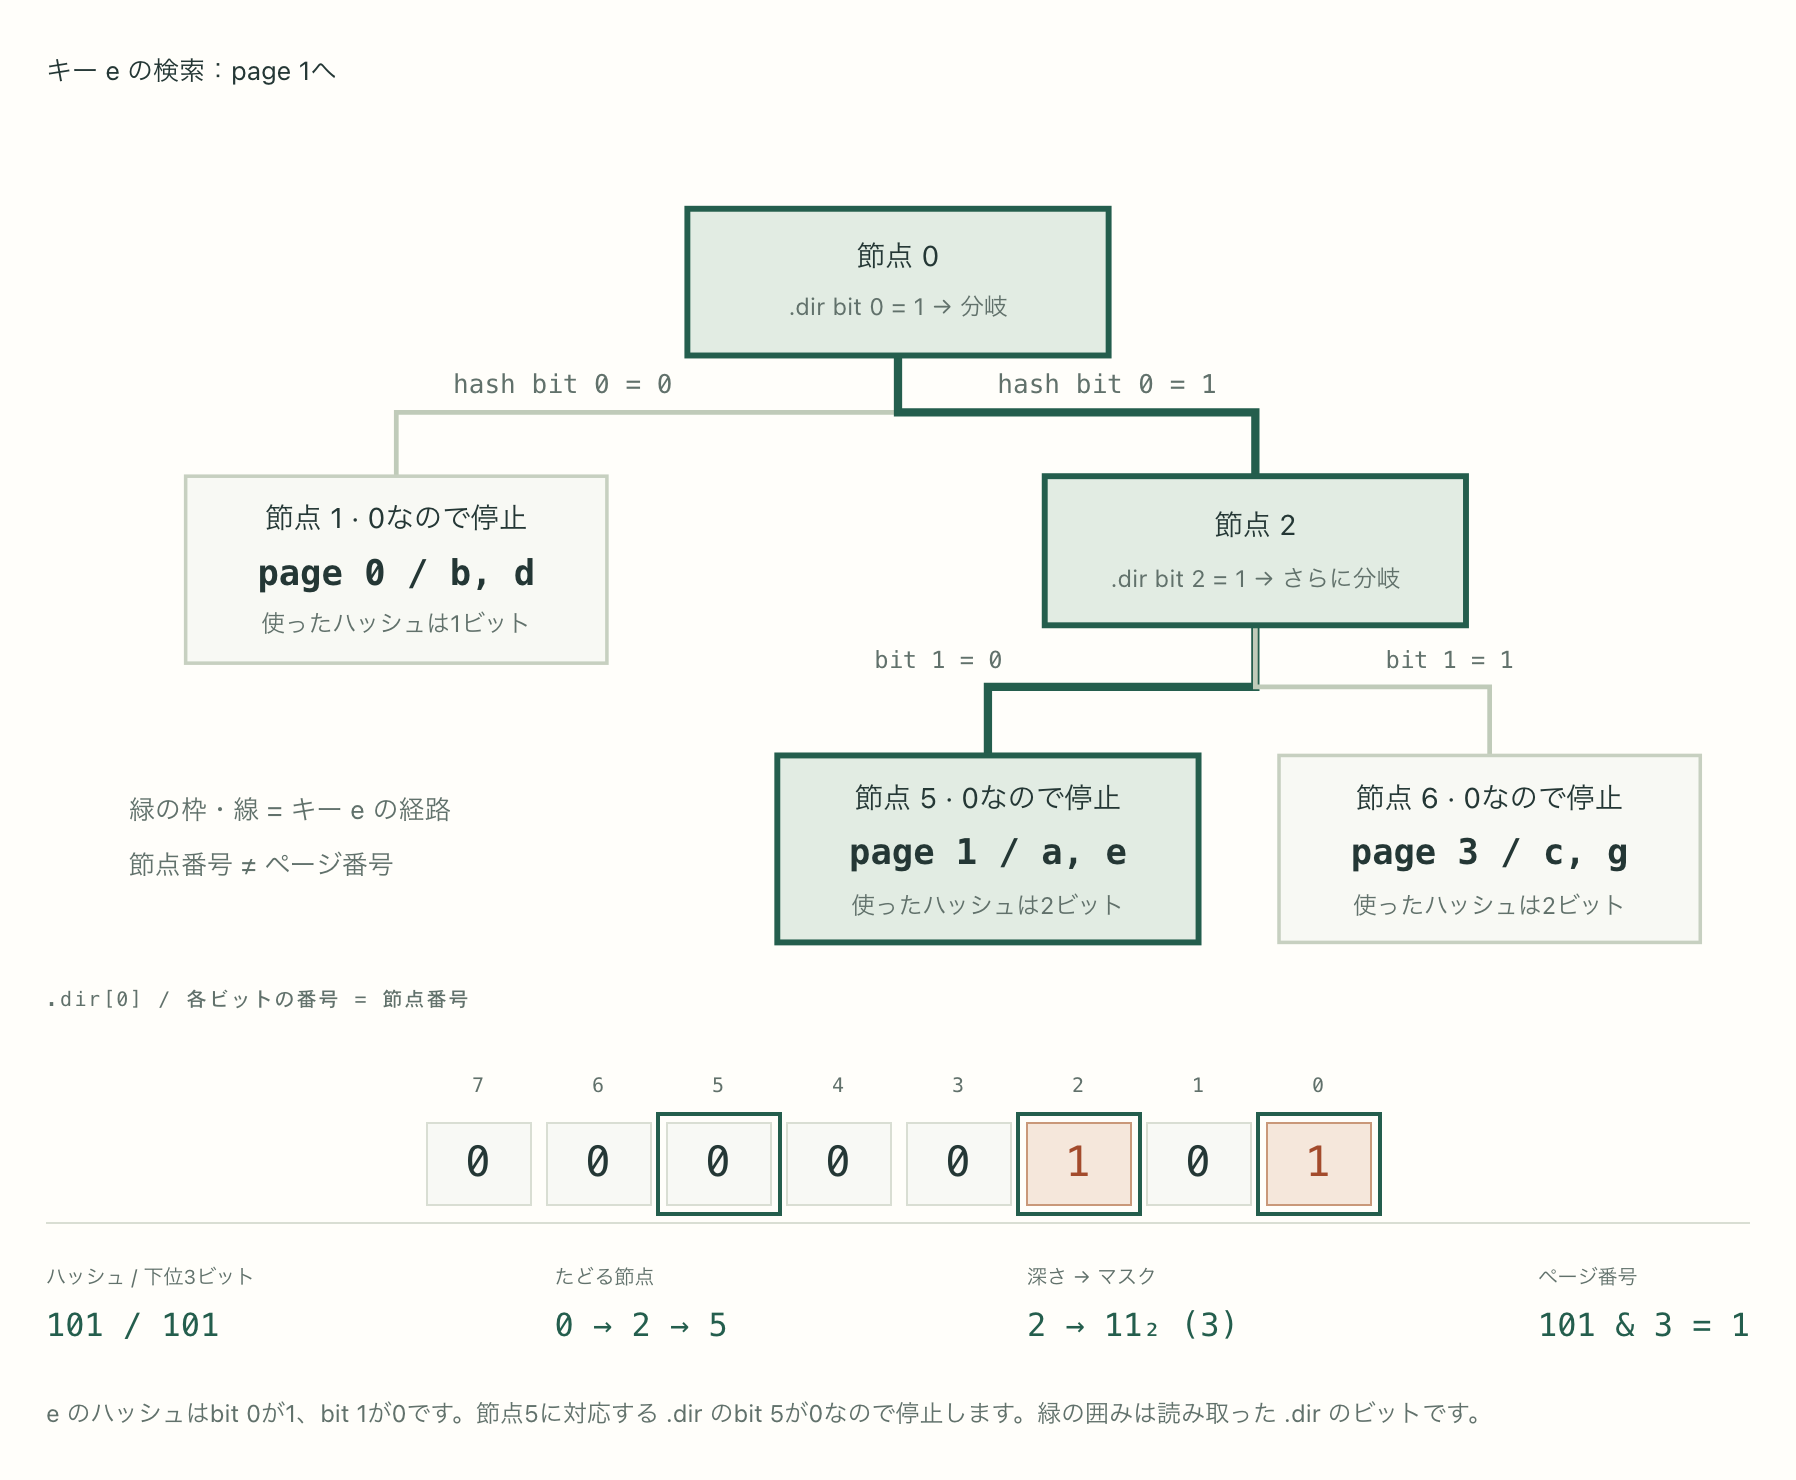
b を探す場合、根の節点0の記録は1なので分岐します。ハッシュ98のbit 0は0なので、左の節点1へ進みます。節点1の記録は0なので、ここで停止。使ったハッシュは1ビットだけです。
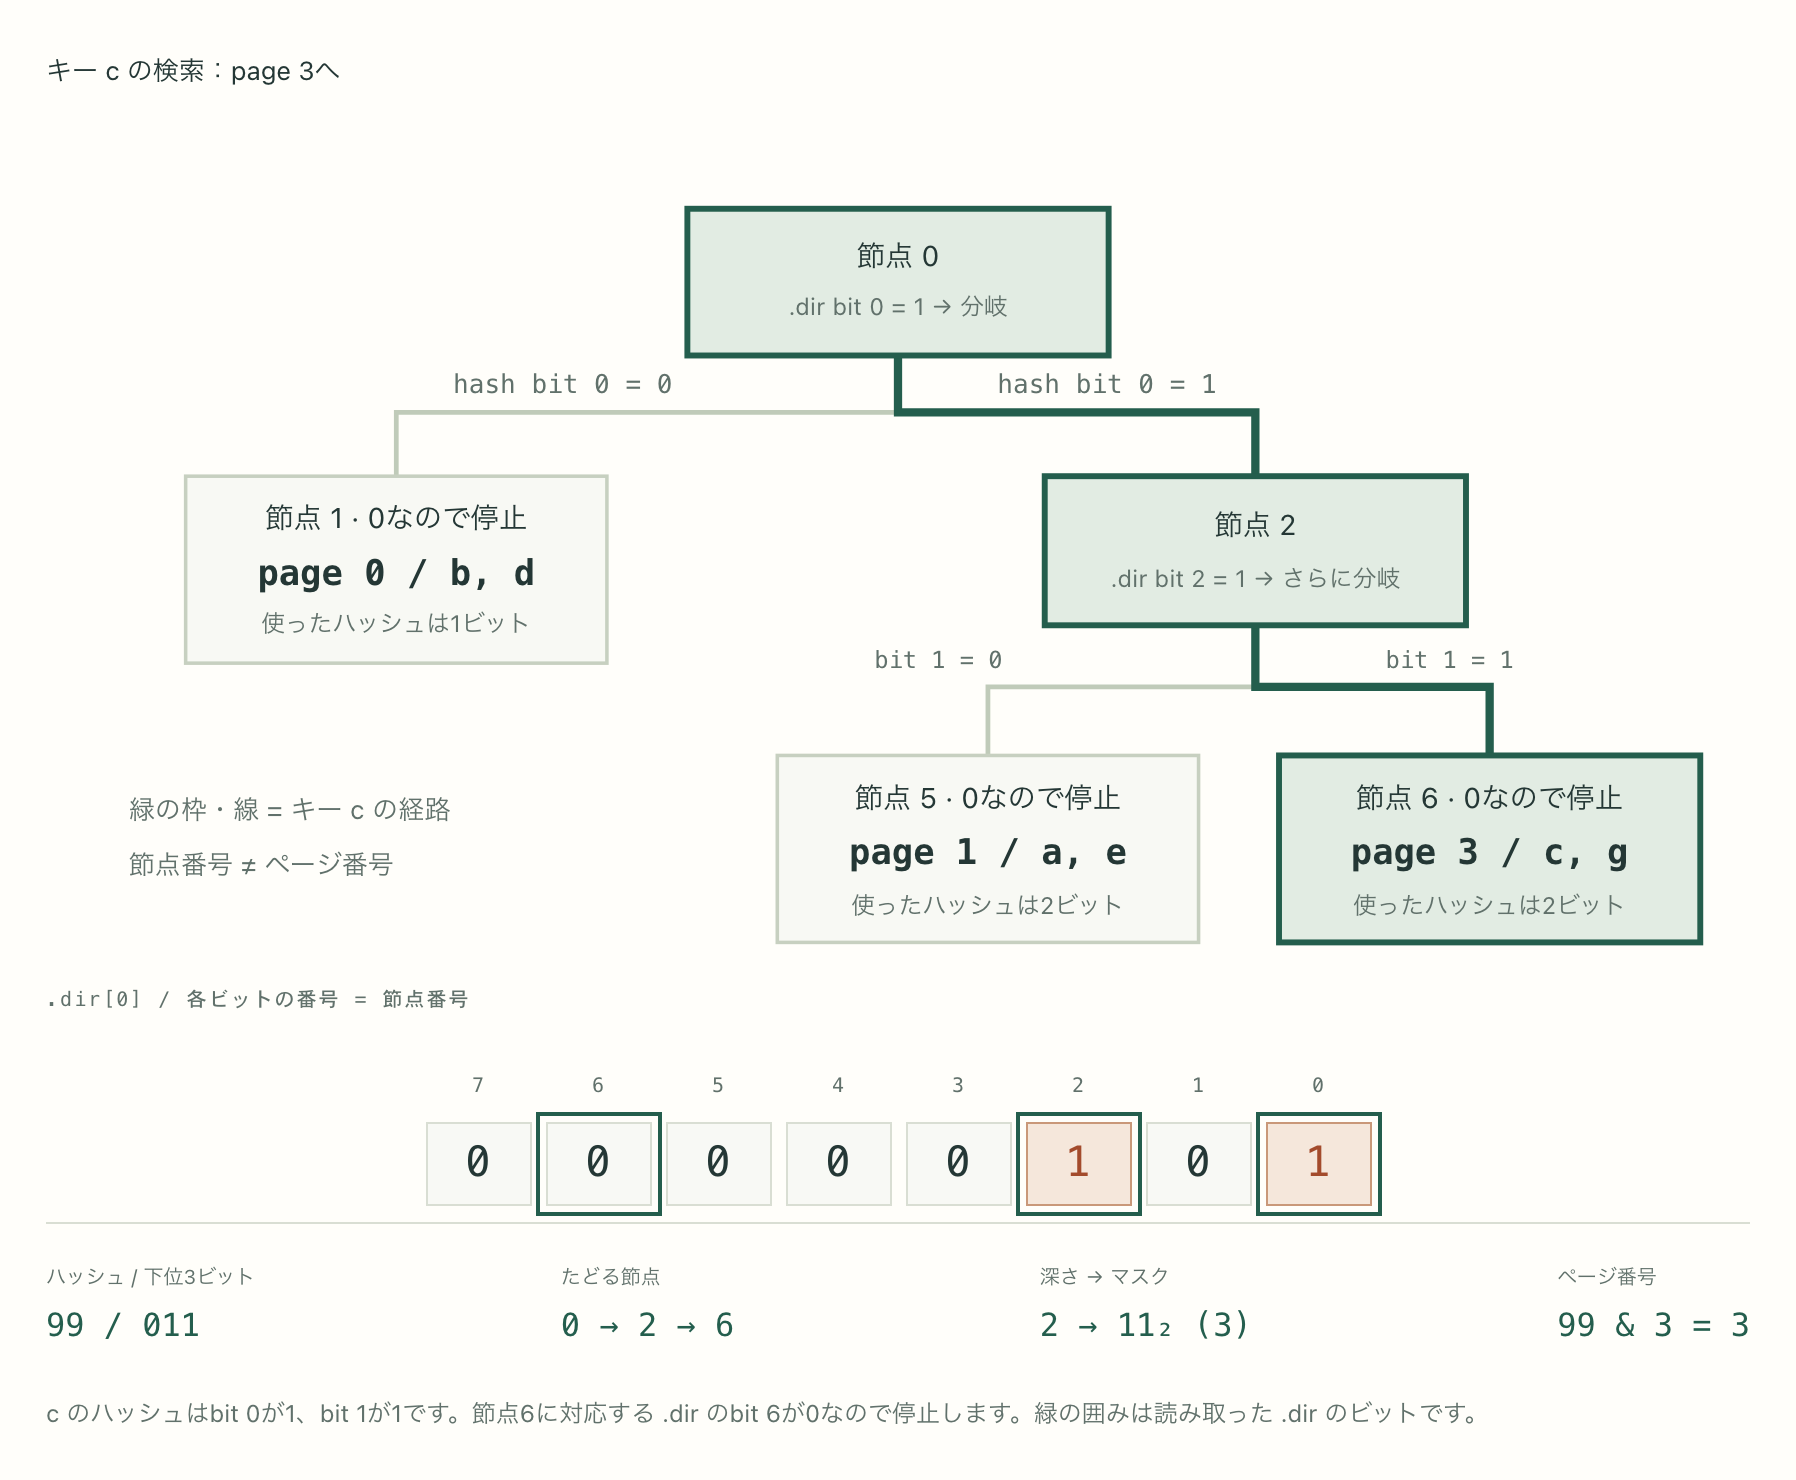
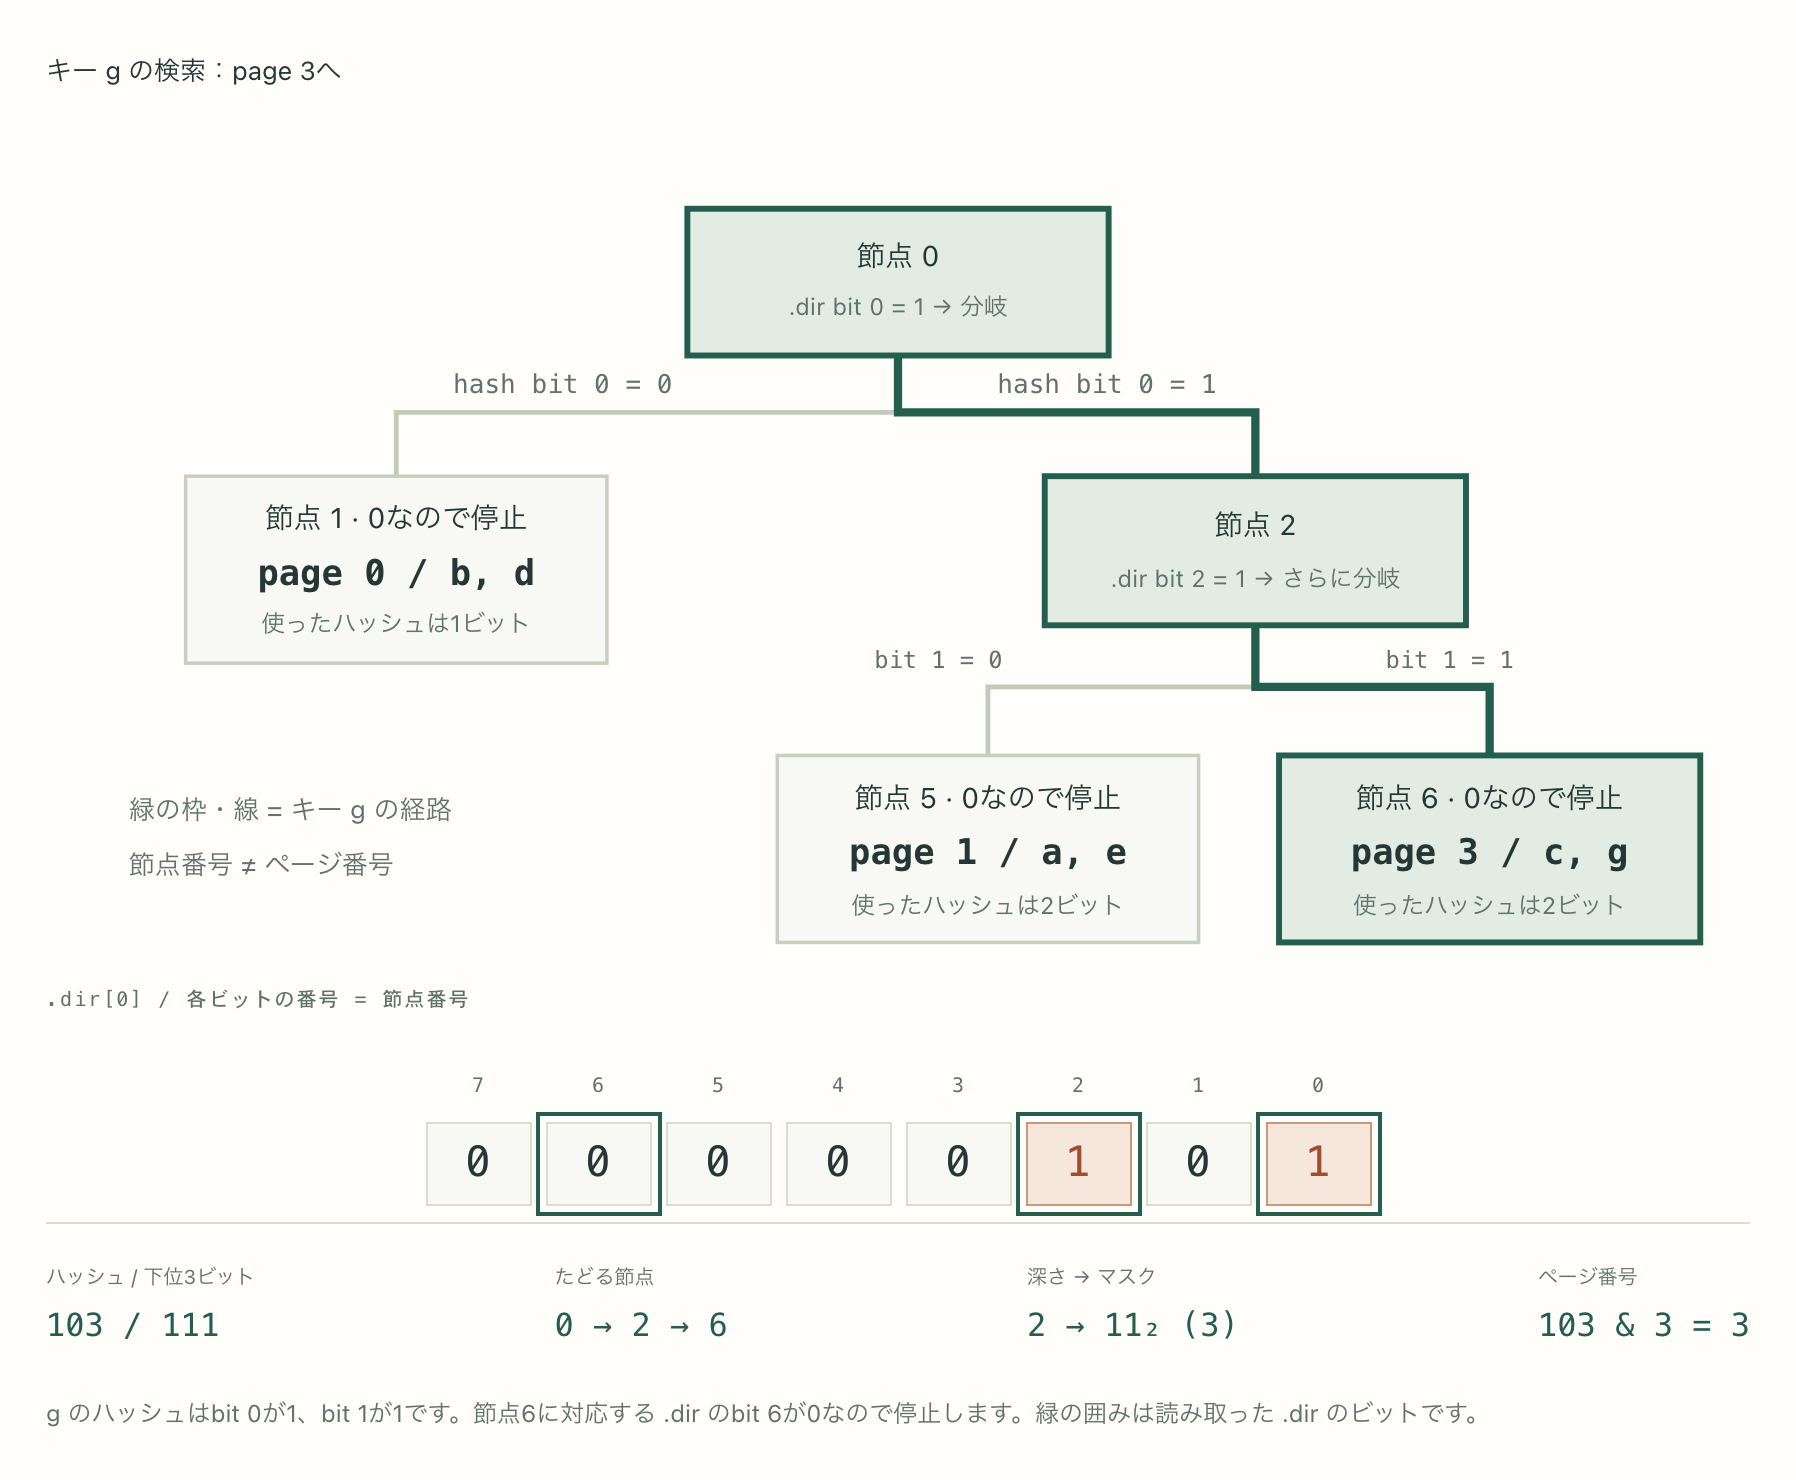
c を探す場合も、根から始めます。ハッシュ99のbit 0は1なので、右の節点2へ進みます。節点2の記録も1なので、今度はbit 1を調べます。これも1なので右の節点6へ進み、記録が0なので停止します。こちらはハッシュを2ビット使いました。
使ったビット数から、ページ番号を求める
ここまでで、検索するキーについて、ハッシュを何ビット使えばよいかが分かりました。次は、そのキーと値が入ったページを .pag ファイルから読み込みます。そのために必要なのが、読み込むページの位置を指定するページ番号です。
.pag は1024バイトのページを並べたファイルで、先頭からpage 0、page 1、page 2、…と番号を付けています。ページ番号が分かれば、ページ番号 × 1024 バイトの位置から、そのページを読み込めます。例えばpage 3なら、ファイルの先頭から3072バイトの位置にある1024バイトを読み、その中でキーを探します。
ページ番号には、ここまで左右の分岐を選ぶために使った、ハッシュのビットを使います。例えば c の検索では、最初にbit 0を調べて右へ進み、次にbit 1を調べてもう一度右へ進みました。この二つはハッシュの右端の2ビットで、どちらも1です。この 11 を一つの2進数として読むと3になるため、読み込むのはpage 3です。
b の検索では、bit 0が0なので左へ進み、そこで止まりました。使ったのは右端の1ビットだけで、その値は 0 なので、読み込むのはpage 0です。このように、ページ番号は使ったハッシュの下位ビットから求めます。停止した節点の番号とは別です。
ハッシュの右端から必要なビットだけを取り出すために、マスクという整数を使います。マスクは、残したい位置を1、それ以外を0にします。右端の1ビットを残すなら 00000001(10進数で1)、右端の2ビットを残すなら 00000011(10進数で3)です。ハッシュとマスクの & を計算すると、右端の必要なビットがそのまま残り、それ以外は0になります。
根から分岐した回数を木の深さと呼びます。この検索では、深さが使ったハッシュビット数です。深さを d とすると、マスクは (1 << d) − 1、ページ番号は hash & mask で求められます。
必要な下位ビットを残すと、ページ番号になる
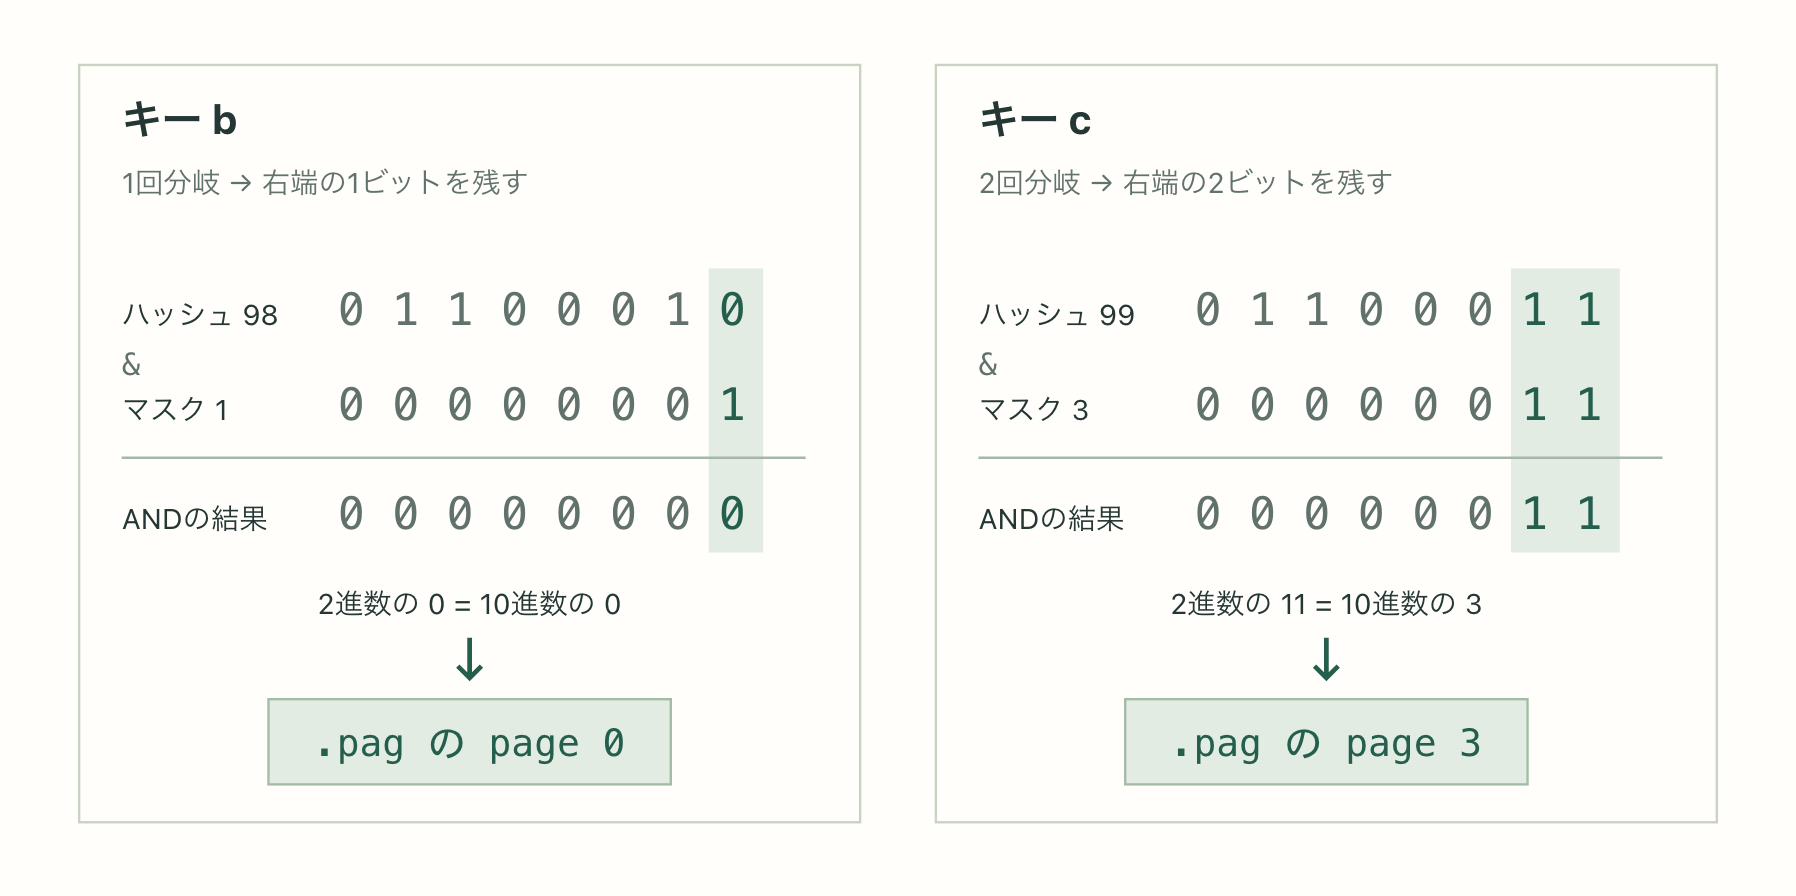
緑の列が、マスクで残すビット位置です。& は同じ位置のビットが両方1のときだけ1を返すため、マスクが0の位置は結果も0になります。図ではハッシュの下位8ビットを示し、それより上のビットは省略しています。
キーごとの検索経路を比べる
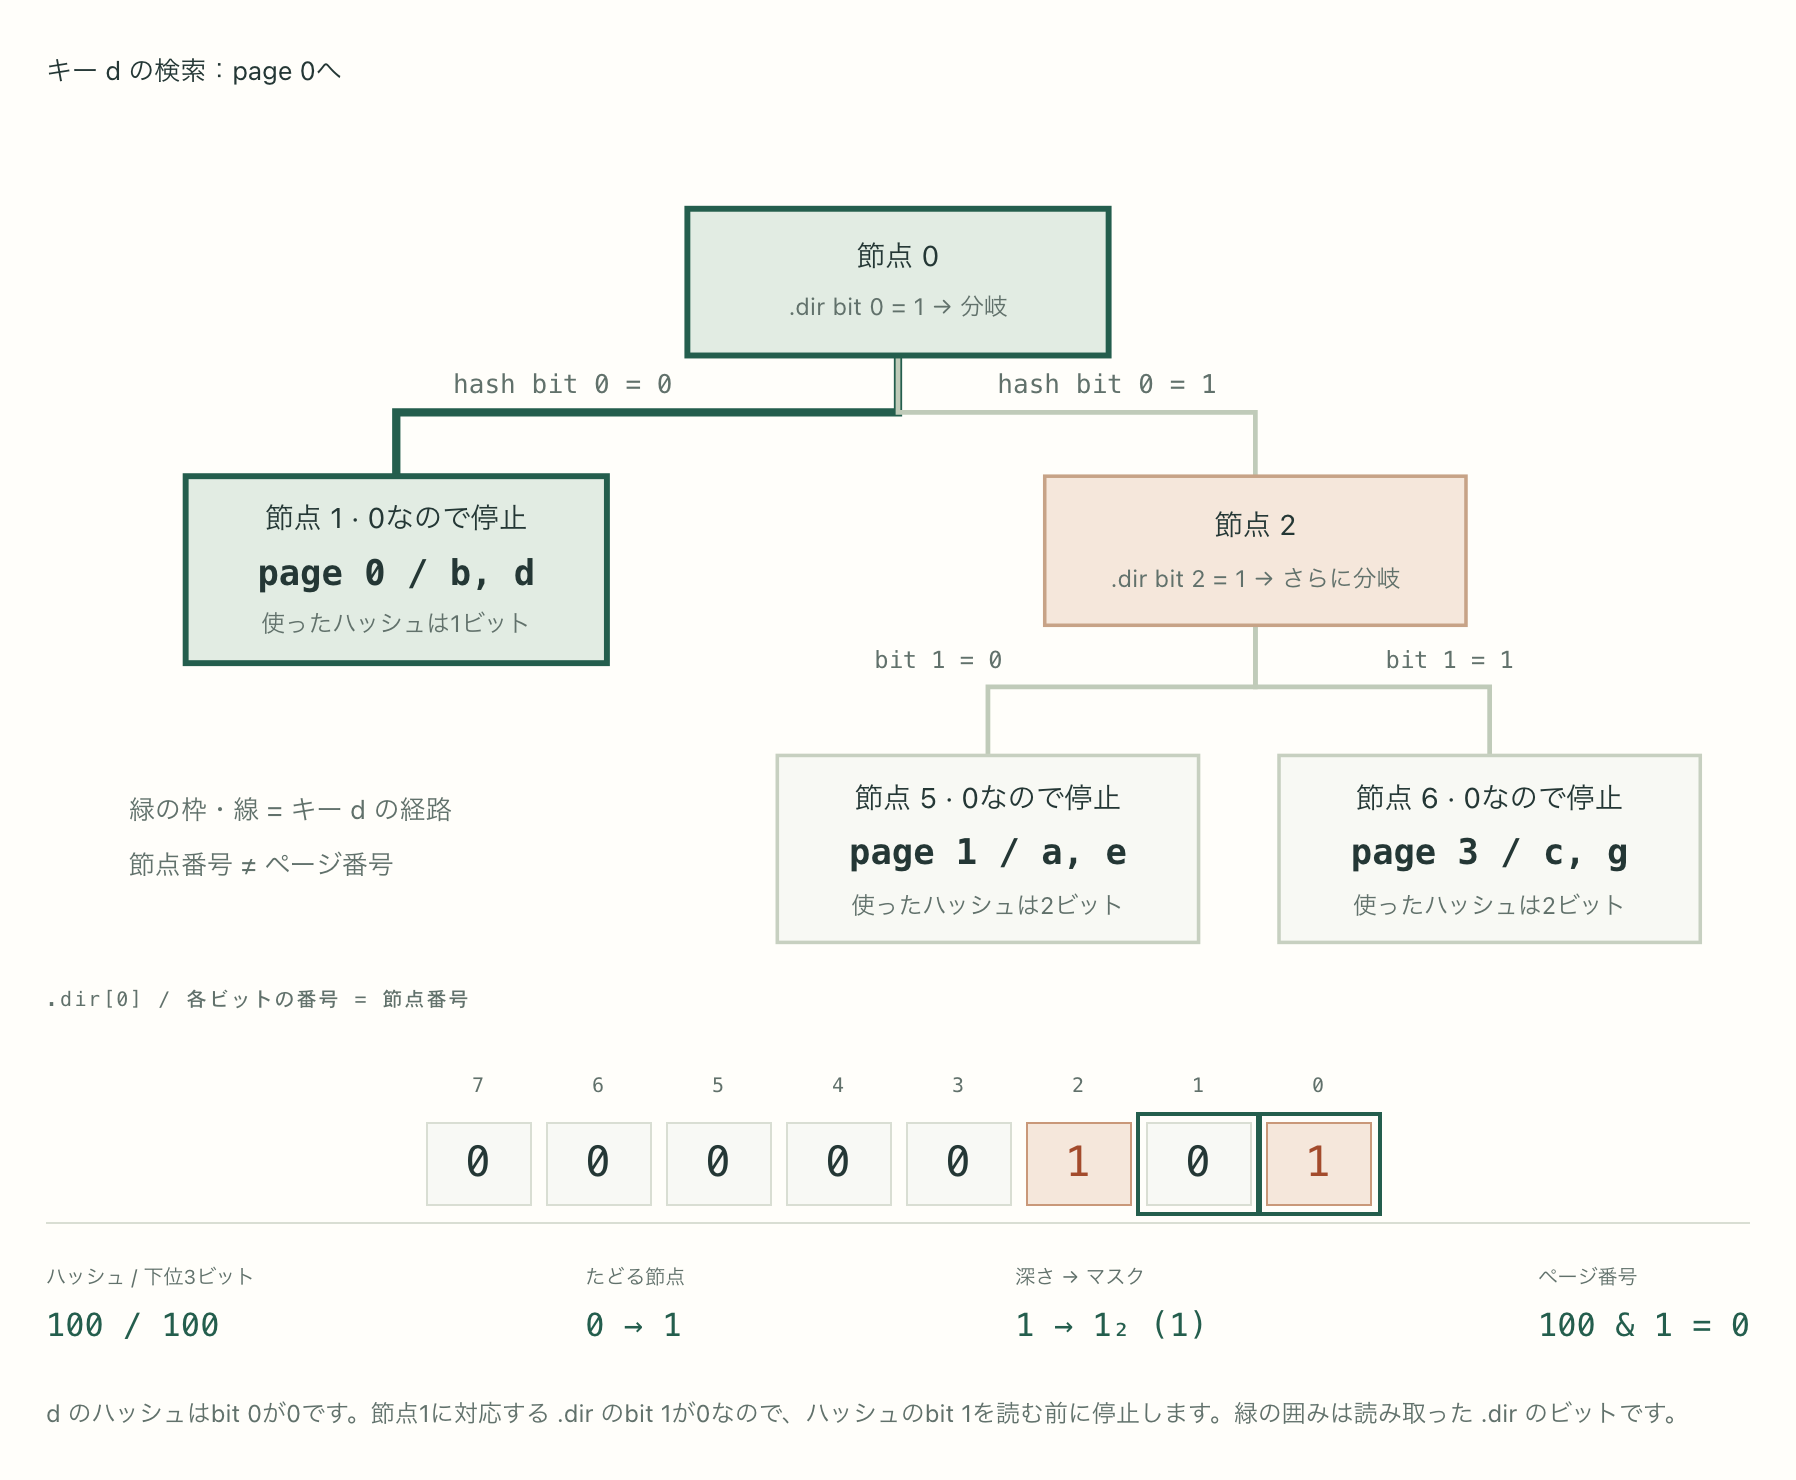
次の6枚の図は、キーごとに、たどる節点と読み取る .dir のビットを緑で示しています。b が1回の分岐で止まり、c が2回分岐することや、使うマスクの違いを確認してみてください。
キー a の検索経路
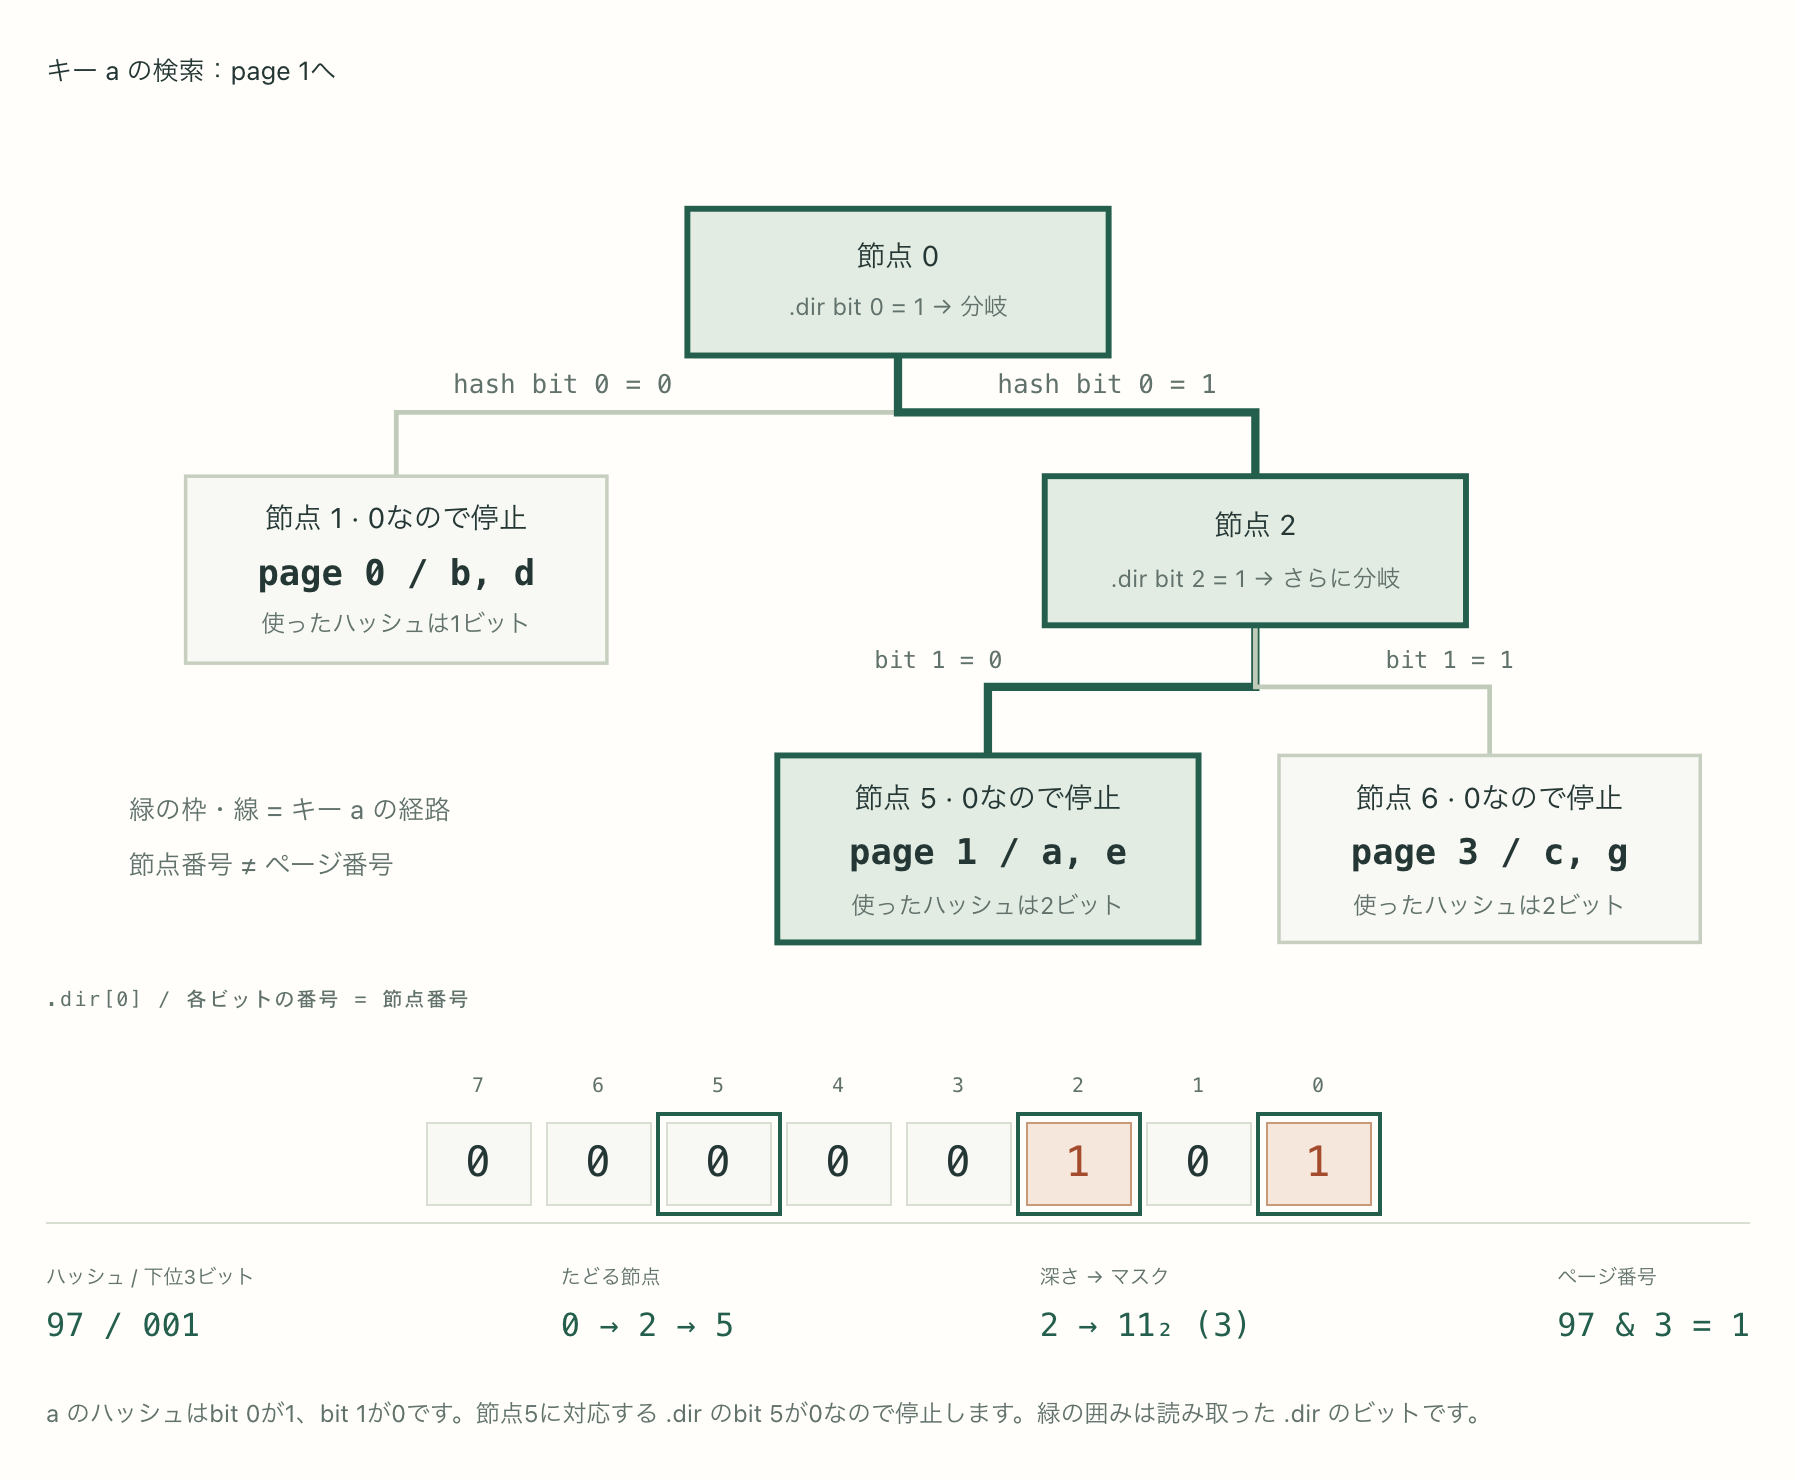
ビット列の右端がbit 0です。節点番号は .dir を読むための番号であり、.pag のページ番号とは別です。
キー b の検索経路
キー c の検索経路
キー d の検索経路
キー e の検索経路
キー g の検索経路
検索の手順をGoのコードで読む
ここまで図で追った「分岐するかを確認する → ハッシュで左右を選ぶ → 使ったビット数からページ番号を求める」という手順を、Goのコードで確かめます。キーのハッシュを受け取り、保存先のページを選んで必要に応じて読み込むのが getPage メソッドです。次は、そのうちページ番号を求めるまでの抜粋です。hash には計算済みのハッシュが渡されており、キーが c なら99です。
GO · getPage 抜粋 sdbm.go ↗
var dbit, hbit int64
for dbit < db.maxbno && db.getDBit(dbit) {
    if hash&(1<<hbit) != 0 {
        dbit = 2*dbit + 2 // 右の子
    } else {
        dbit = 2*dbit + 1 // 左の子
    }
    hbit++
}
db.curbit = dbit
db.hmask = masks[hbit]
pagb := hash & db.hmask
二つの変数を0から始める。var dbit, hbit int64 で宣言した変数は、どちらも初期値が0です。dbit は、今いる節点の番号。0なので根から始めます。hbit は、次に調べるハッシュのビット位置。こちらも0なので、右端のbit 0から調べます。
for の条件で、今いる節点が分割済みかを確認する。db.maxbno は、.dir のファイル長に対応するビット数です。まず dbit < db.maxbno で、節点番号に対応するビットがその範囲内にあるかを確認します。範囲内なら、getDBit(dbit) が .dir のその位置を読み、ビットが1なら true を返します。二つの条件が両方成り立つ間だけ、ループの中へ進みます。範囲外か、記録が0の節点に着いたら、そこで分岐を終えます。
if でハッシュの1ビットを調べ、左右を選ぶ。1 << hbit は、調べたい位置だけを1にした整数です。hbit が0なら 0001、1なら 0010 になります。hash & (1 << hbit) が0以外なら、その位置のビットは1なので、2*dbit + 2 で右の子へ進みます。0なら、2*dbit + 1 で左の子へ進みます。更新しているのは節点番号の dbit です。
hbit++ で、次に調べる位置を一つ進める。
1回分岐するごとに hbit を1増やし、移動先の節点で再び for の条件を確認します。このため、hbit は「次に調べるビット位置」であると同時に、「ここまでに使ったビット数」にもなります。c なら節点を 0 → 2 → 6 と進み、bit 0とbit 1を使ったところで停止するので、終了時は dbit = 6、hbit = 2 です。
ループの後で、検索結果を保存し、ページ番号を求める。db.curbit = dbit は、停止した節点の番号をDBの状態として保存します。挿入時にそのページを分割することになった場合、この番号の .dir のビットを1にします。続く masks は、下位ビットを取り出すマスクを 0, 1, 3, 7, … の順に並べた配列です。masks[hbit] で使ったビット数に対応するマスクを選び、db.hmask に保存します。c なら masks[2] = 3 なので、最後の行は 99 & 3 = 3。ページ番号を表す変数 pagb に3が入ります。
この抜粋の後では、求めたページがすでに内部バッファにあるかを確認し、なければ .pag の pagb × 1024 バイトの位置から読み込みます。値を取得する Fetch メソッドは、getPage から戻った後、そのページの中でキーを比較して値を取り出します。
ループの条件に使った getDBit は、節点番号 dbit に対応する分割記録を調べます。次は、必要なブロックをメモリ上の配列 db.dirbuf に読み込む処理を省略した抜粋です。
GO · getDBit 抜粋 sdbm.go ↗
c := dbit / BITSIZ
dirb := c / DBLKSIZ

// 省略:必要なら dirb のブロックを db.dirbuf に読み込む処理

return int(db.dirbuf[c%DBLKSIZ]&(1<<(dbit%BITSIZ))) != 0
BITSIZ = 8 なので、c は対象ビットが入るファイル内のバイト位置です。dirb は4096バイト単位のブロック番号、c % DBLKSIZ はそのブロック内のバイト位置を表します。dbit % BITSIZ でバイト内のビット位置を求め、AND演算でそのビットだけを調べます。例えば節点2なら、先頭バイトの 0x04 のビットを調べるため、記録が 0x05 なら true になります。
ビットで左右を選ぶこの木を二分トライ、分岐の有無をビットで並べた記録をビットマップと呼びます。SDBMは、この記録から必要なハッシュビット数を判断し、片側だけを分割した後も保存先を見つけます。
キーから、ファイルのバイト位置へ
page 1を分割すると、なぜpage 3ができるのか
g を追加するとき、page 1が満杯になり、新しくpage 3を使いました。page 2を飛ばす理由は、前章で見た「ハッシュの下位ビットをページ番号にする」という決め方にあります。分割するときも、後で検索するときも、同じビットから同じページ番号を求められる必要があります。
分割前のpage 1には、ハッシュの右端のbit 0が1のキーが集まっています。ここをさらに分けるときは、左隣のbit 1を調べます。もともと同じだった右端の1はそのままで、新しく調べるbit 1が0か1かによって、保存先が二つに分かれます。
a, eはbit 1が0。右端の2ビットは01で、10進数では1なので、page 1に残ります。c, gはbit 1が1。右端の2ビットは11で、10進数では3なので、page 3に入ります。既存のcを移し、その後でgを追加します。
右端の1はそのまま、左隣のビットで分ける
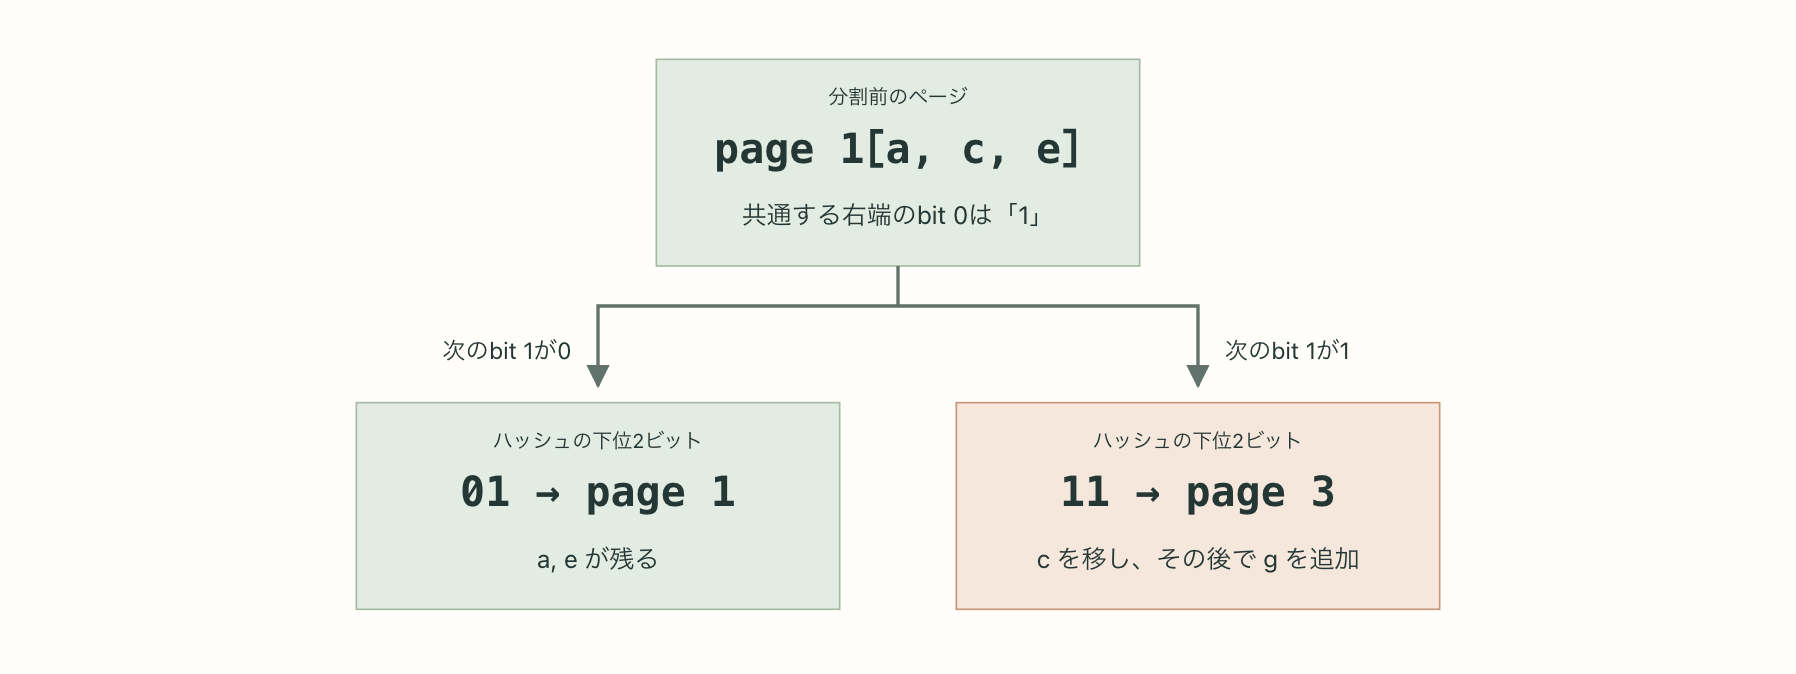
2ビットの並びは、左がbit 1、右がbit 0です。右端の1を保ったまま左隣で分けるので、保存先は 01(1)と 11(3)になります。
一方、ページ番号2を2進数で書くと 10 です。右端のbit 0が0なので、今回分割するpage 1のキーには当てはまりません。page 2を使うのは、bit 0が0のキーが集まるpage 0を、さらにbit 1で分割するときです。今回、page 0にはまだ空きがあるため、そこは分割しません。
この番号の決め方をコードで表したのが、makeRoom メソッドの次の一行です。newp は、分割で作る新しいページの番号です。
GO · makeRoom 抜粋 sdbm.go ↗
newp = (hash & db.hmask) | (db.hmask + 1)

// g の挿入時。分割前のマスクは1、ハッシュは103。
// 元のページ番号:103 & 1 = 1  (2進数で01)
// 次の分割ビット:  1 + 1 = 2  (2進数で10)
// 新しいページ番号:01 | 10 = 11 → page 3
hash & db.hmask で分割前のページ番号を求め、db.hmask + 1 で次に調べるビットの位置だけを1にします。| は、同じ位置のビットがどちらか一方でも1なら、結果を1にする演算です。元のページ番号 01 に、新しく使うbit 1の 10 を重ねると 11 になり、新ページの番号3が求まります。
page 3は、.pag の先頭から 3 × 1024 = 3072 バイトの位置にあります。そこへ1024バイトを書き込むと、ファイルの長さは4096バイトになります。page 2に当たる [2048, 3072) の範囲にはペアを書き込んでいないため、未使用の領域として残ります。
.pag の中で、page 2 が空く
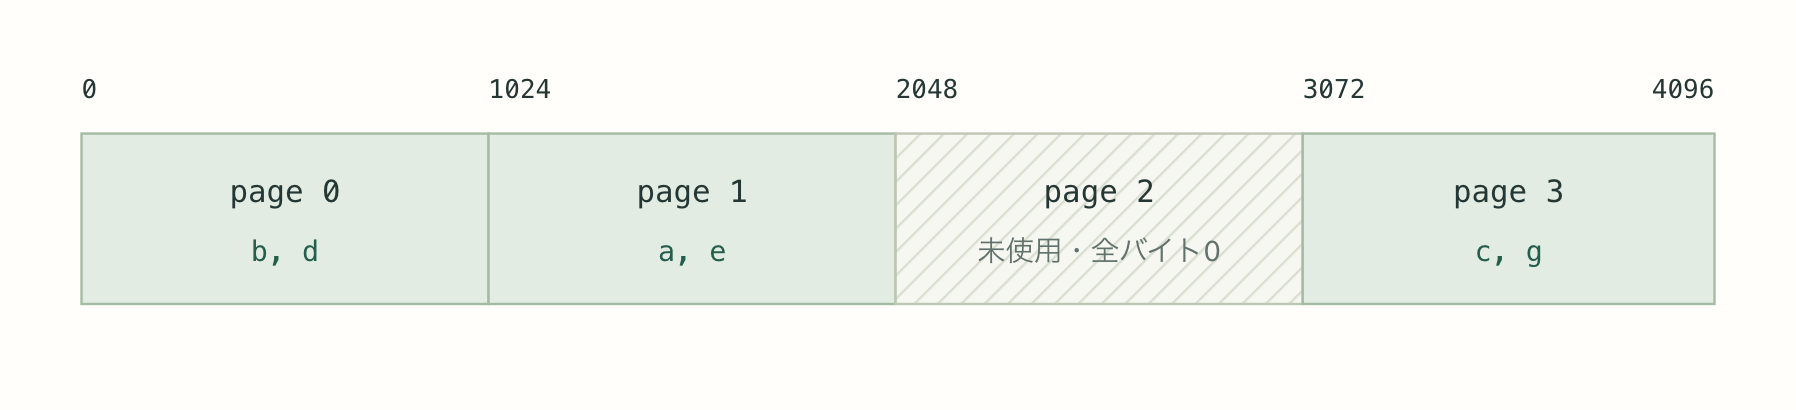
左の枝が未分割なので、bit 0が0のキーはpage 0に集まります。page 2が必要になるのは、この枝をさらに分割するときです。4096 Bは論理的なファイル長で、実際のディスク割り当て量とは区別します。
閉じて、開き直しても、同じ場所へ行ける
.dir には分割の記録が、.pag には各ページのオフセット表とキー・値の本体が残っています。DBを閉じて開き直しても、.dir の記録とキーのハッシュからページ番号を求め、.pag からそのページを読み込めます。ページ内でキーを比較し、オフセット表を使って値を切り出す手順も同じです。サンプルでは、再オープン後に取得した6件すべての300バイトの値が、保存した内容と一致しました。
キー c から、値のバイト範囲まで追う
検索の5ステップ
- キーからハッシュを計算する
sdbm.Hash([]byte("c"))の結果は99。bit 0とbit 1はどちらも1。
- .dir をたどり、ページ番号を決める
- 節点0 → 2 → 6。深さ2なのでマスクは3、
99 & 3 = 3。
- 節点0 → 2 → 6。深さ2なのでマスクは3、
- page 3 の先頭へ移動する
- ファイル内の開始位置は
3 × 1024 = 3072バイト。
- ファイル内の開始位置は
- ページ内でキーを探し、表から値を切り出す
cの値はページ内の[723, 1023)。長さは300バイト。
- ファイル内の位置へつながる
[3072 + 723, 3072 + 1023)。つまり[3795, 4095)に、cを300個並べた値があります。
6件の挿入後、削除前の状態を説明しています。サンプルはこの後に c, g を削除するため、実行終了後のファイルではこの検索は成功しません。ページの選択とページ内の境界がつながる様子は、削除前の観測値で確認します。
全件列挙では、ページを順に読む
全件を列挙するときは、FirstKey メソッドで最初のキーを取得し、NextKey メソッドで続きのキーを取得します。内部ではページを順に読み、各ページのキーを取り出します。この例の列挙順は b, d, a, e, c, g。キーの辞書順や、全体の挿入順ではありません。07 / WRITES & LIMITS
書き込みの単位と制約
.dirは1ビットの変更でも4KBを書き込む
ここまで見てきた .pag は、1024バイトのページ単位で読み書きします。一方、分割の記録を持つ .dir は、4096バイトずつまとめて読み書きします。このように、ファイルを読み書きするために区切った一定の大きさの領域を、ここではブロックと呼びます。.dir のブロックサイズは、定数 DBLKSIZ = 4096 で定めています。
.dir に分割済みの印を記録するのが、setDBit メソッドです。変更する分岐情報は1ビットですが、書き込むのは、そのビットを含む4096バイトのブロック全体です。最初の分割で .dir は0から4096バイトに増え、先頭バイトが 0x01 から 0x05 に変わるときも、先頭の4096バイトをまとめて書きます。変更する情報量と、ファイルに書き込む量は異なります。
Go実装は、現在扱っている .pag の1ページ分(1024バイト)と、.dir の1ブロック分(4096バイト)を、それぞれメモリ上の配列に保持します。このように、ファイルから読んだ内容や、これから書く内容を一時的に置く領域がバッファです。
setDBit の次の抜粋では、対象ブロックを db.dirbuf に読み込む処理と、記録範囲の管理を省略しています。ビットの更新時には、対象ブロックが配列に入っています。
GO · setDBit 抜粋 sdbm.go ↗
c := dbit / BITSIZ
dirb := c / DBLKSIZ

// 省略:必要なら dirb のブロックを db.dirbuf に読み込む処理

db.dirbuf[c%DBLKSIZ] |= 1 << (dbit % BITSIZ)

// 省略:記録の範囲が広がった場合に db.maxbno を更新する処理

if err := seekWrite(db.dirf, offDir(dirb), io.SeekStart, db.dirbuf[:]); err != nil {
    return err
}

return nil
|= は既存のビットを残したまま、指定したビットを1にします。節点2を分割済みにすると、0x01 | 0x04 = 0x05 です。一方、seekWrite に渡す db.dirbuf[:] は4096バイトの配列全体です。offDir(dirb) で対象ブロックのファイル位置を求め、変更していないバイトも含めて書き込みます。
分割から挿入まで、どの順に書き込むか
g を追加するときの処理で確かめます。まず makeRoom メソッドが、page 1にある既存のペアをメモリ上で二つのページに分けます。page 1には a, e を残し、page 3には c を移します。この時点では、まだ g は追加していません。
page 1は a, e が入った状態で今回の更新が終わるので、先に .pag へ書き込みます。page 3にはこの後で g を追加するため、c が入った内容をメモリ上のバッファに保持しておきます。続いて、.dir に分割済みの印を記録します。
page 3に g を入れる空きができたので、makeRoom から Store メソッドに戻ります。Store は、バッファにあるpage 3へ g を追加し、c, g が入った状態を .pag へ書き込みます。page 3の内容はメモリにあるため、追加のためにファイルから読み直す必要がありません。ファイルへの書き込み順は、次のようになります。
g を挿入するときのメモリと書き込み
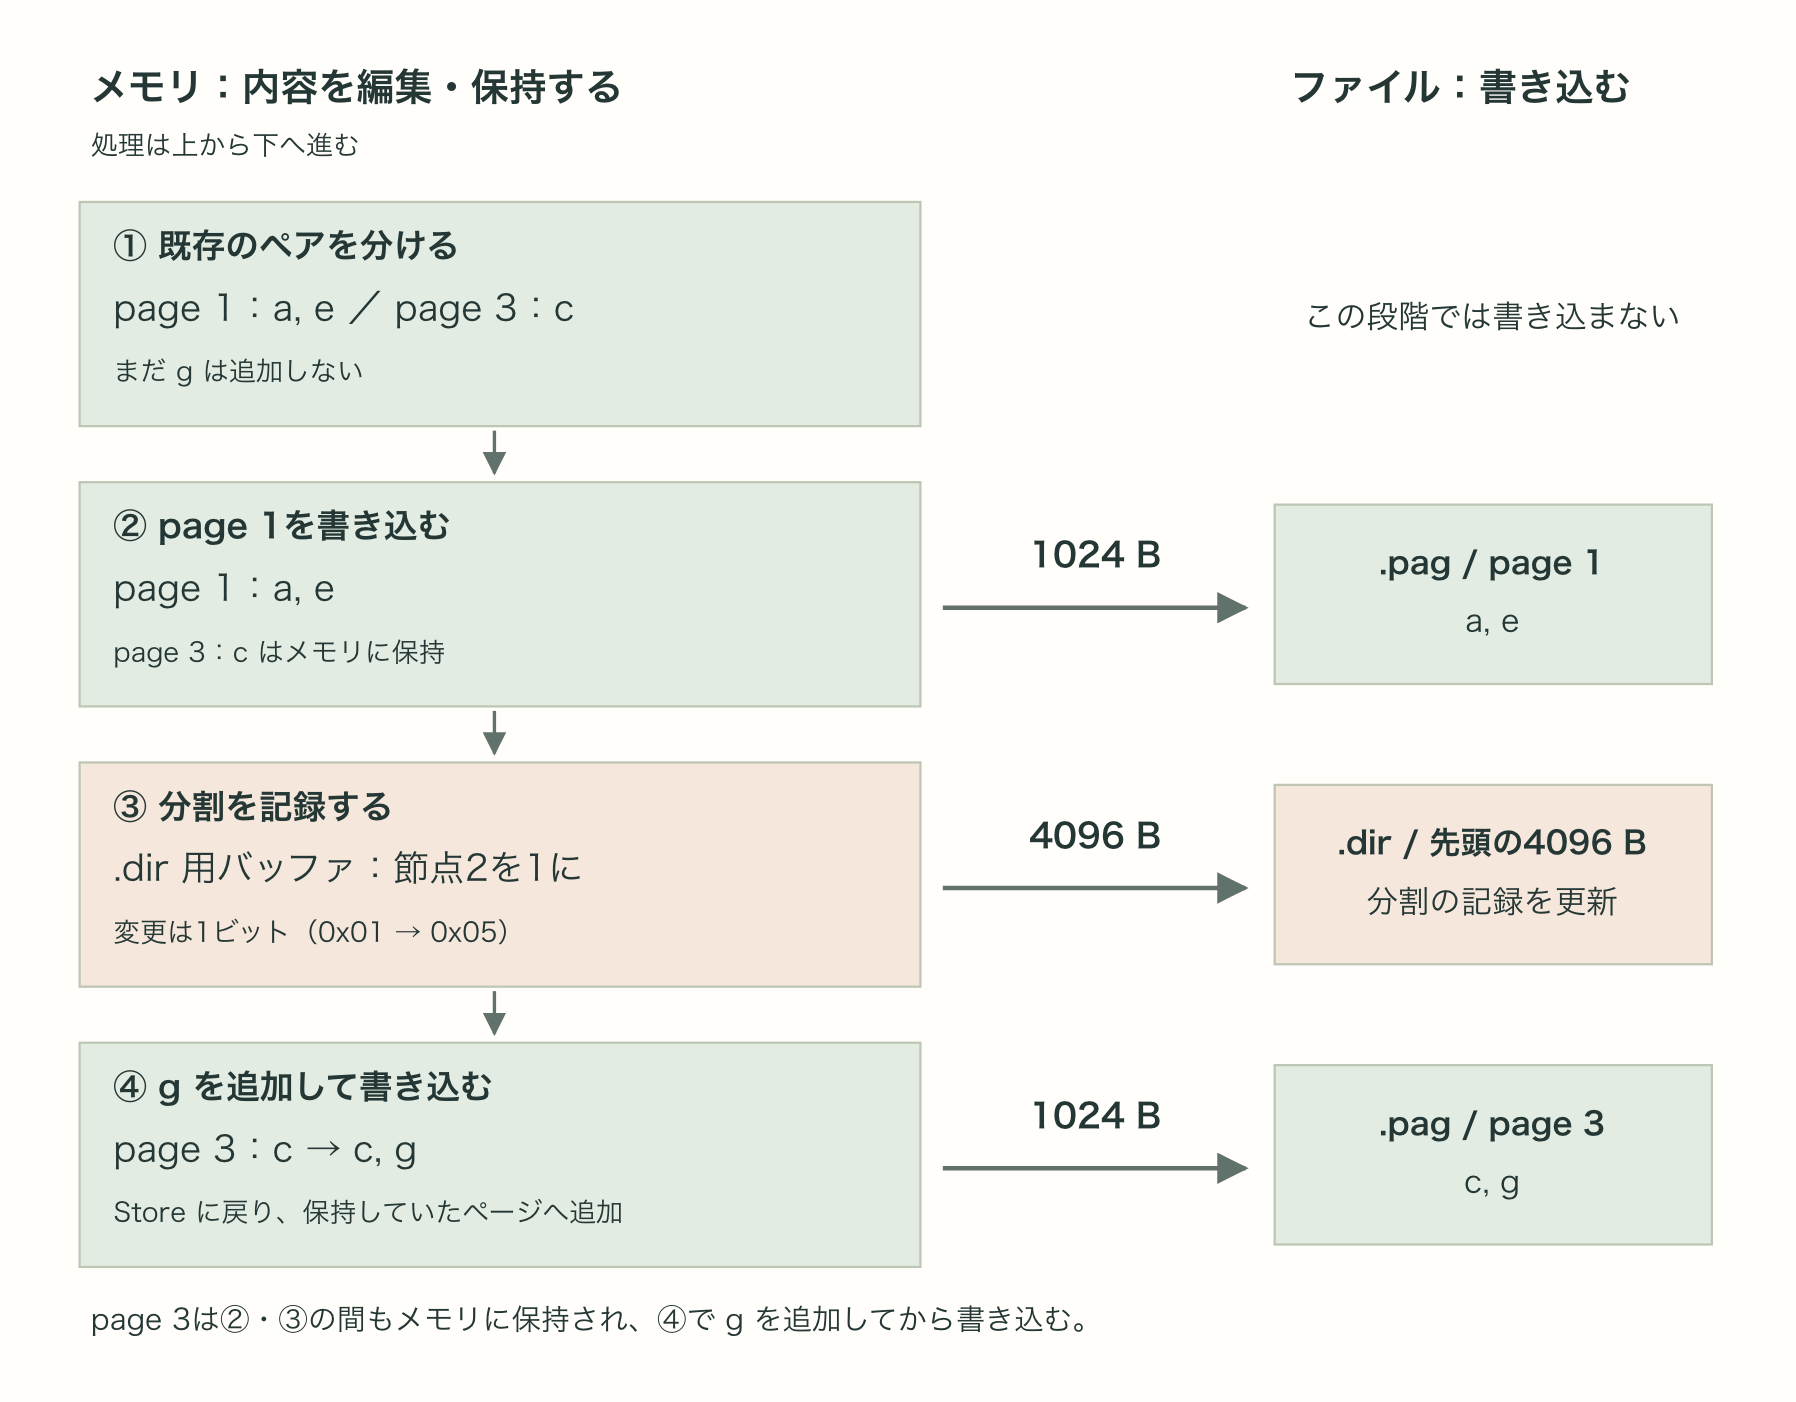
縦の矢印は処理の順序を、メモリからファイルへ向かう横の矢印は os.File.Write の呼び出しを表します。横の矢印に添えた数値は、書き込むバイト数です。③で変更する分割記録は1ビットですが、そのビットを含む4096バイト全体を書き込みます。図はストレージへの永続化の順序や物理I/Oの単位を保証するものではありません。この例では1回の分割で空きができます。分割を繰り返す場合は、途中でも挿入先を書き出します。
保存容量と分割・削除の制約
キー+値の上限(1008 B)
定数 PAIRMAX で定めた上限です。大きな値を複数ページにまたがって保存する処理はありません。
1挿入の分割上限 (10回)
定数 SPLTMAX で定めた上限です。ハッシュ全体が同じキーは、分割を重ねても分かれません。
空になっても縮まない(併合なし)
page 3の c, g を削除しても、両ファイルは4096 B、分割記録は 0x05 のままです。
破損の検出と、復旧の保証は別
ページの構造を検査する ChkPage メソッドは、オフセットの個数や大小関係を検査します。ただし、任意の破損をすべて検出できるわけではありません。また、ページの構造が正しいことと、複数の書き込みがまとめて完了することも、別の話です。
この実装には、更新を先にログへ記録するWALやトランザクション処理がありません。DBのファイルを閉じる Close メソッドも、ファイルの内容をストレージへ同期する os.File.Sync メソッドを明示的には呼びません。図の途中で処理が途切れる可能性を考えると、正常な再オープンの成功は、電源断後の復旧を保証するものではないと分かります。
C版とのファイル互換性は、どの条件で成り立つ?
READMEが示す前提は、little-endian、LP64(long が64ビット)、signed charです。Goのハッシュは各バイトを int8 として扱い、オフセットはlittle-endianで書きます。C側のデータモデルや文字の符号の扱いが変われば、互換性の前提も変わります。
リポジトリには、GoとCのハッシュ比較、ページ操作後のバイト比較、Cが作ったDBの読み取り、同じ操作で生成したファイルのハッシュ比較が用意されています。詳細は README、compat_test.go、compat_db_test.go を参照してください。08 / READ, RUN, EXPLORE
サンプルを動かし、ファイルの中身を確かめる
この記事の実験は、Go 1.23.0以上で実行できます。リポジトリのルートで、次のコマンドを使ってください。
go run ./examples/sdbm-walkthrough
実行ごとに新しい一時ディレクトリが作られ、先頭の Files: に場所が出ます。small と growth の二つのDBは実行後も残ります。本文の観測値はGo 1.24.0・macOS arm64・CGO_ENABLED=0 のサンプル実行と照合しています。
実行後に残るのは、最後の削除まで終えた状態です。small は b の削除後で、キーは a, c。growth は再オープンと6件の取得確認の後に c, g を削除し、キーは b, d, a, e、page 3は空になります。図の途中状態は各段階の出力と照合してください。
途中状態をファイルに残したい場合は、対象の操作直後、次のDB操作に進む前に、.pag と .dir の両方を別名でコピーする処理をサンプルに追加してください。サンプル内の snapshot 関数は、その時点のファイルを読み、内容を表示します。その状態のファイルを別途保存する処理はありません。
実行結果の抜粋を見る
OUTPUT · 実行結果の抜粋
small: a -> apple: pag=1024 dir=0 dir[0]=empty
  page 0: n=2 keys=[a] offsets=[1023 1018] free=1012
  header=02 00 ff 03 fa 03 tail="applea"

(途中の出力を省略)

small: delete b: pag=1024 dir=0 dir[0]=empty
  page 0: n=4 keys=[a c] offsets=[1023 1018 1017 1011] free=1001
  after Delete(b): borrowed="cherry" copied="banana"

(途中の出力を省略)

growth: insert g: pag=4096 dir=4096 dir[0]=0x05
  page 0: n=4 keys=[b d] offsets=[1023 723 722 422] free=412
  page 1: n=4 keys=[a e] offsets=[1023 723 722 422] free=412
  page 2: n=0 keys=[] offsets=[] free=1022
  page 3: n=4 keys=[c g] offsets=[1023 723 722 422] free=412
  page 0 unchanged: true
reopen: all six values verified
iteration: [b d a e c g]

growth: delete c and g: pag=4096 dir=4096 dir[0]=0x05
  page 0: n=4 keys=[b d] offsets=[1023 723 722 422] free=412
  page 1: n=4 keys=[a e] offsets=[1023 723 722 422] free=412
  page 2: n=0 keys=[] offsets=[] free=1022
  page 3: n=0 keys=[] offsets=[] free=1022
ソースを読むなら、この順に
- pair.go ↗
- FitPair・PutPair・GetPair・DelPair
- まず1ページの中の操作を読む。
- hash.go ↗
- Hash
- キーが整数に変わる過程を確かめる。
- sdbm.go ↗
- getPage・makeRoom・setDBit
- ページの選択とファイルI/Oをつなぐ。
- walkthrough/main.go ↗
- smallExample・growthExample
- APIの操作とバイト列を一緒に追う。
まとめ
SDBMでは、配列とオフセット表で可変長のキーと値を管理し、ハッシュのビットでページを分割します。分割の記録は二分トライとビットマップで表され、検索時の保存先を決めます。Goのコードとバイト配置を追うことで、これらのデータ構造が保存・削除・分割・検索をどう支えるのかを確かめました。
そこから学べるのは、データ構造の選び方が、操作に必要な処理とコストを決めるという関係です。何を記録し、何を比較し、どのデータを動かすのか。古典的KVSの小さな実装は、データ構造とアルゴリズムを結び付けて理解する教材になりました。
謝辞
最後に、SDBMを生み出したOzan Yigit氏に感謝します。小さな実装の中に、データの配置から保存先の分割までを収めたSDBMは、データ構造とアルゴリズムを実際のコードから学ぶ貴重な教材でした。Goで再実装しながら、その仕組みを一つずつ理解することができました。ありがとうございます。